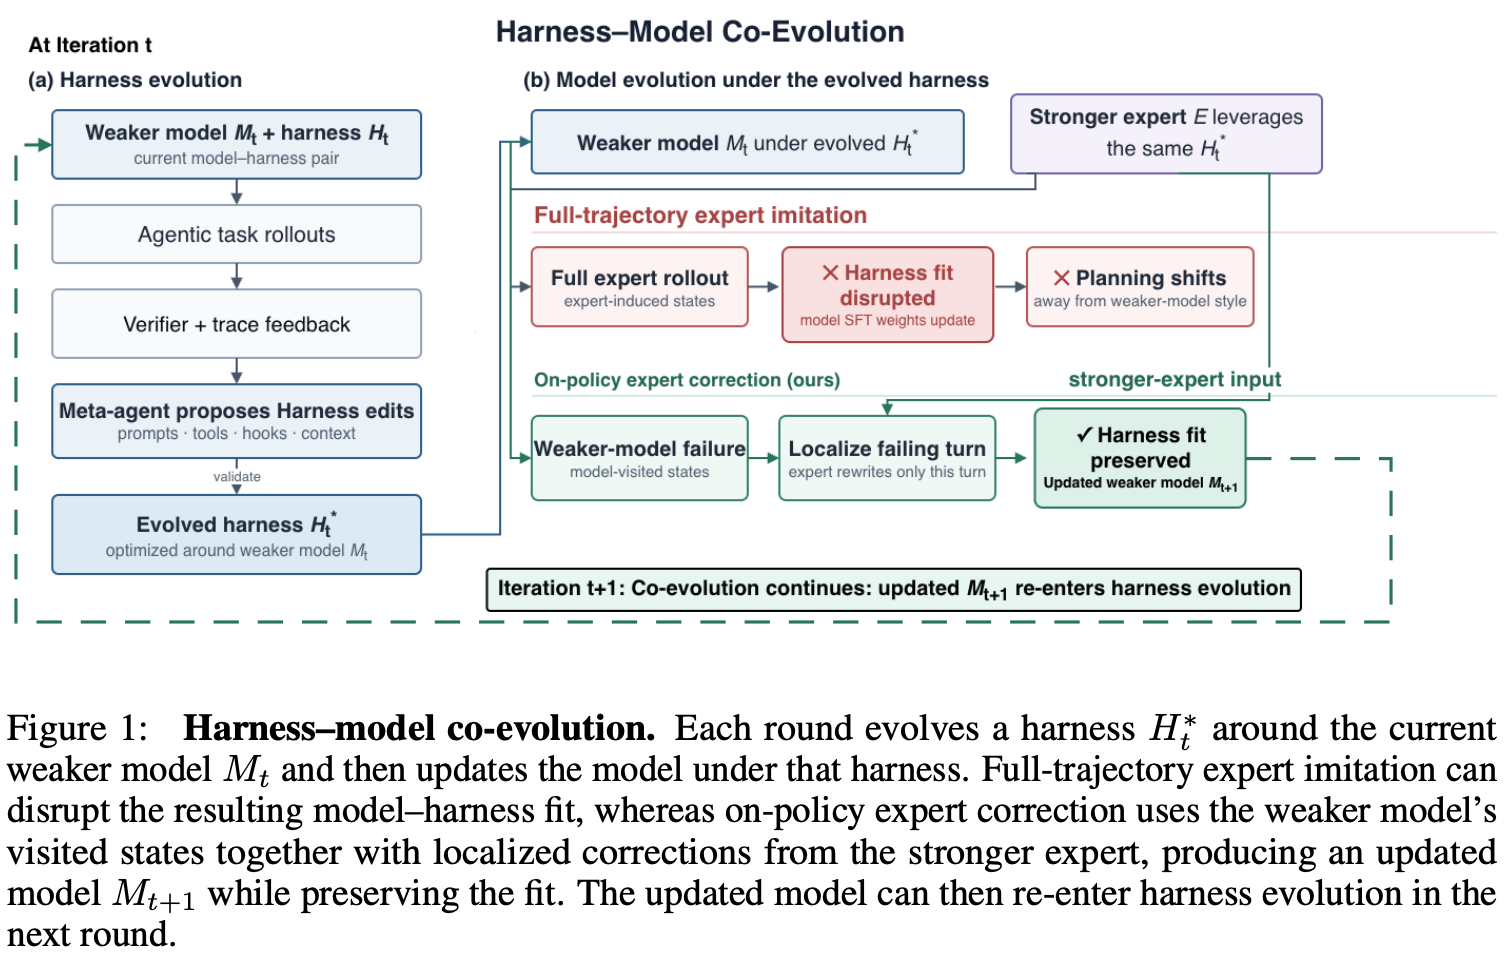
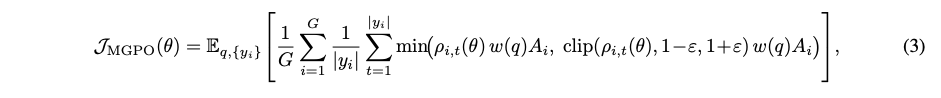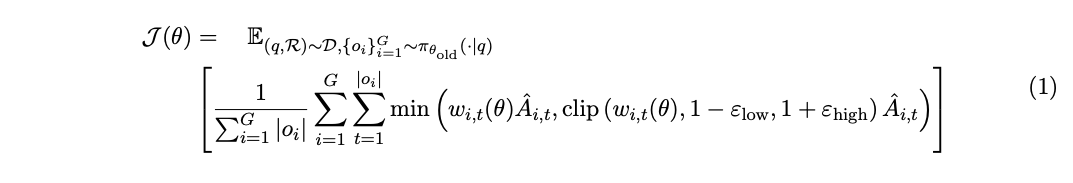큰 모델이 그 턴만 다시 작성 (계획 및 스타일은 보존) → 큰 모델의 지식 습득 + 하네스 적합성 유지 = 두 이득 동시 확보
결론: 하네스 진화 ↔ 모델 가중치 적응 사이의 충돌 지점을 규명 및 해소 → 공동 진화(co-evolution) 루프에 통합 가능한 레시피 제시
1. Introduction
배경: 에이전트 능력 = 모델 + 하네스(관찰/행동 범위를 결정하는 스캐폴딩). 하네스를 자동으로 탐색·최적화하면 작은 모델도 프론티어급에 근접 가능 (특히 비용이 중요한 엔터프라이즈 태스크에서 유용)
연구 초점: 전반적인 모델 능력 향상이 아니라, 특정 도메인에서 하네스 × 모델을 같이 진화시키는 것. 모델 쪽 레버는 LoRA-SFT 같은 경량 파인튜닝으로 한정
핵심 질문: 정해진 예산 안에서 하네스 진화와 경량 파인튜닝을 어떻게 조합해야 시너지가 나고, 서로 성능 상쇠가 안되나?
자연스러운 가설:
선행 연구 -- 전문가 궤적은 효과적인 학습 신호, 하네스는 모델 백본 간에도 전이가 잘 됨
실제로 확인해보니: 작은 모델용으로 진화시킨 하네스를 큰 모델에 줘도 잘 씀 (오히려 더 잘 씀) → 그럼 "하네스 먼저 진화 + 큰 모델 궤적으로 작은 모델 파인튜닝"하면 되지 않을까? 라는 단순한 레시피가 떠오름
반전:
막상 해보면 성능이 일관되게 떨어짐 (7개 태스크 전부)
근데 같은 절차를 default 하네스에 적용하면 오히려 도움이 됨 → 문제는 "모방 학습" 자체가 아니라 "모방 × 하네스 진화"의 조합에서 생김
원인 진단:
성능 하락이 하네스를 덜 쓰거나 지식이 없어져서가 아님 (둘 다 SFT 후 오히려 하네스 사용이 늘어남)
진짜 원인은 계획 전략의 이탈: 작은 모델이 자기 역량이 되는지 안 되는지 모른 채로 큰 모델의 계획·전략만 그대로 받아들임 → 원래 자기 스타일에 맞춰 진화된 하네스와 더 이상 안 맞게 됨
해결책: 교사 신호를 on-policy로 줌
메타-레벨 MLE 에이전트가 작은 모델 자신의 롤아웃에서 실패 턴을 정확히 찾아냄
큰 모델은 그 턴만 다시 작성 → 나머지 턴(작은 모델의 계획·스타일)은 그대로 보존
기여(Contributions) 3가지:
상향 전이 확인: 7개 태스크에서 큰 모델이 작은 모델용 하네스를 쉽게, 심지어 더 효과적으로 사용함 → 모든 태스크에서 작은 모델을 능가하고, 큰 모델 자신의 default 하네스보다도 잘함 → 작은 모델에게 아직 못 쓰는 여유 역량이 있다는 뜻
전체 궤적 모방은 실패: 하네스 진화 후 큰 모델 궤적으로 SFT → 7개 태스크 전부 −4~−30점 하락, Qwen3-Coder·Gemma 4 두 계열에서 재현. 근데 default 하네스에서는 같은 절차가 이득 → 실패는 "모방×하네스진화" 조합에 국한된 문제. 원인은 지식/하네스 활용도 손실이 아니라 계획 전략 이탈
on-policy 보정으로 해결: MLE 에이전트가 실패 턴을 찾고, 큰 모델이 그 턴만 고쳐씀 → 진화된 하네스가 준 이득 위에 추가 성능 향상 가능, 하네스-모델 공동 진화 루프(Fig.1)에 그대로 끼워 넣을 수 있음
더 넓은 함의: 하네스가 특정 모델에 한번 최적화되고 나면, 하네스와 모델은 더 이상 독립적으로 다룰 수 없음 → 이후 가중치 업데이트는 그 적합성을깨뜨리지 않고 보존해야 함
실무 원칙: 하네스 진화 후엔 큰 모델 궤적을 통째로 모방시키지 말고,작은 모델이 실제로 겪는 상황에서 on-policy로 지도할 것 → 하네스 개선 위에 모델 업데이트를 안전하게 쌓아갈 수 있고, 반복적인 공동 진화가 가능해짐
2. Related Work
하네스 최적화만 다룬 선행 연구: 프롬프트나 하네스 구현을 최적화하면 작은 모델도 복잡한 다단계 툴 사용 태스크를 잘 수행할 수 있음이 이미 확인됨
문제: 하네스 적응과 모델 적응의 경계가 뚜렷하지 않음 → 외부 스캐폴딩으로 도입된 행동이 시간이 지나면서 모델 가중치 안으로 흡수되기도 함 -- 튜닝을 하게 되면 하네스의 structure등이 튜닝의 Weight으로 들어가게됨. 따라서 과거 연구들은 두 레버를 따로 보고 분석하기 어려움
두 레버 (하네스 및 튜닝)를 함께 최적화하려는 최근 시도들:
SIA: 분류·과학 최적화 태스크에서 하네스 업데이트와 모델 업데이트를 번갈아 수행
Co-Harness: 개선된 하네스 하에서, 수학 추론 태스크에 대해 모델 자신의 검증된 성공 궤적으로 파인튜닝
HarnessForge, HarnessX: 모델 정책과 진화하는 하네스를 함께 최적화
이들의 한계: 각자 도메인에서 성능 향상은 보였지만, 하네스가 특정 모델에 특화된 이후 두 레버를 어떻게 조율해야 하는지, 그리고 어떤 조건에서 이후 가중치 업데이트가 그 적합성 위에 쌓이는지 vs 깨뜨리는지는 여전히 불분명
이 논문의 위치: 위 질문을, 특히 더 강한 모델이 만든 신호를 추가 교사 신호로 삼아 장기적(long-horizon) 엔터프라이즈 에이전트 태스크에서 탐구
에이전트 사후학습(post-training) 관련 흐름:
성공적인 전문가 궤적에 대한 지도 파인튜닝은 툴 사용·태스크 완료율을 크게 향상시키는 흔한 방법
최근 연구들(Lauffer et al., Ye et al.)은 전체 궤적을 통째로 모방하는 대신, 학생 모델이 유도한 상태에서 교사가 이어쓰기/개입하는 방식으로 진화
하지만 이들은 고정된 에이전트 인터페이스를 전제로 함 → 지도 신호가 진화된(특정 모델에 맞춰진) 하네스와 어떻게 상호작용하는지는 다루지 않음 -- 하네스를 한번 세팅하고 나서 절대 바꾸지 않음. 다만 지금 다루는 논문에서는 하네스부터 최적화 하고 나서 on-policy함.
이 논문이 연결하는 지점:
전체 전문가 궤적 모방 → 약한 모델과 하네스 사이의 적합성을 깨뜨릴 수 있음
약한 모델이 실제로 방문한 상태에서의 일부분을 전문가 보정 → 적합성을 보존하면서 하네스 적응과 모델 적응이 서로 결합(compose)됨
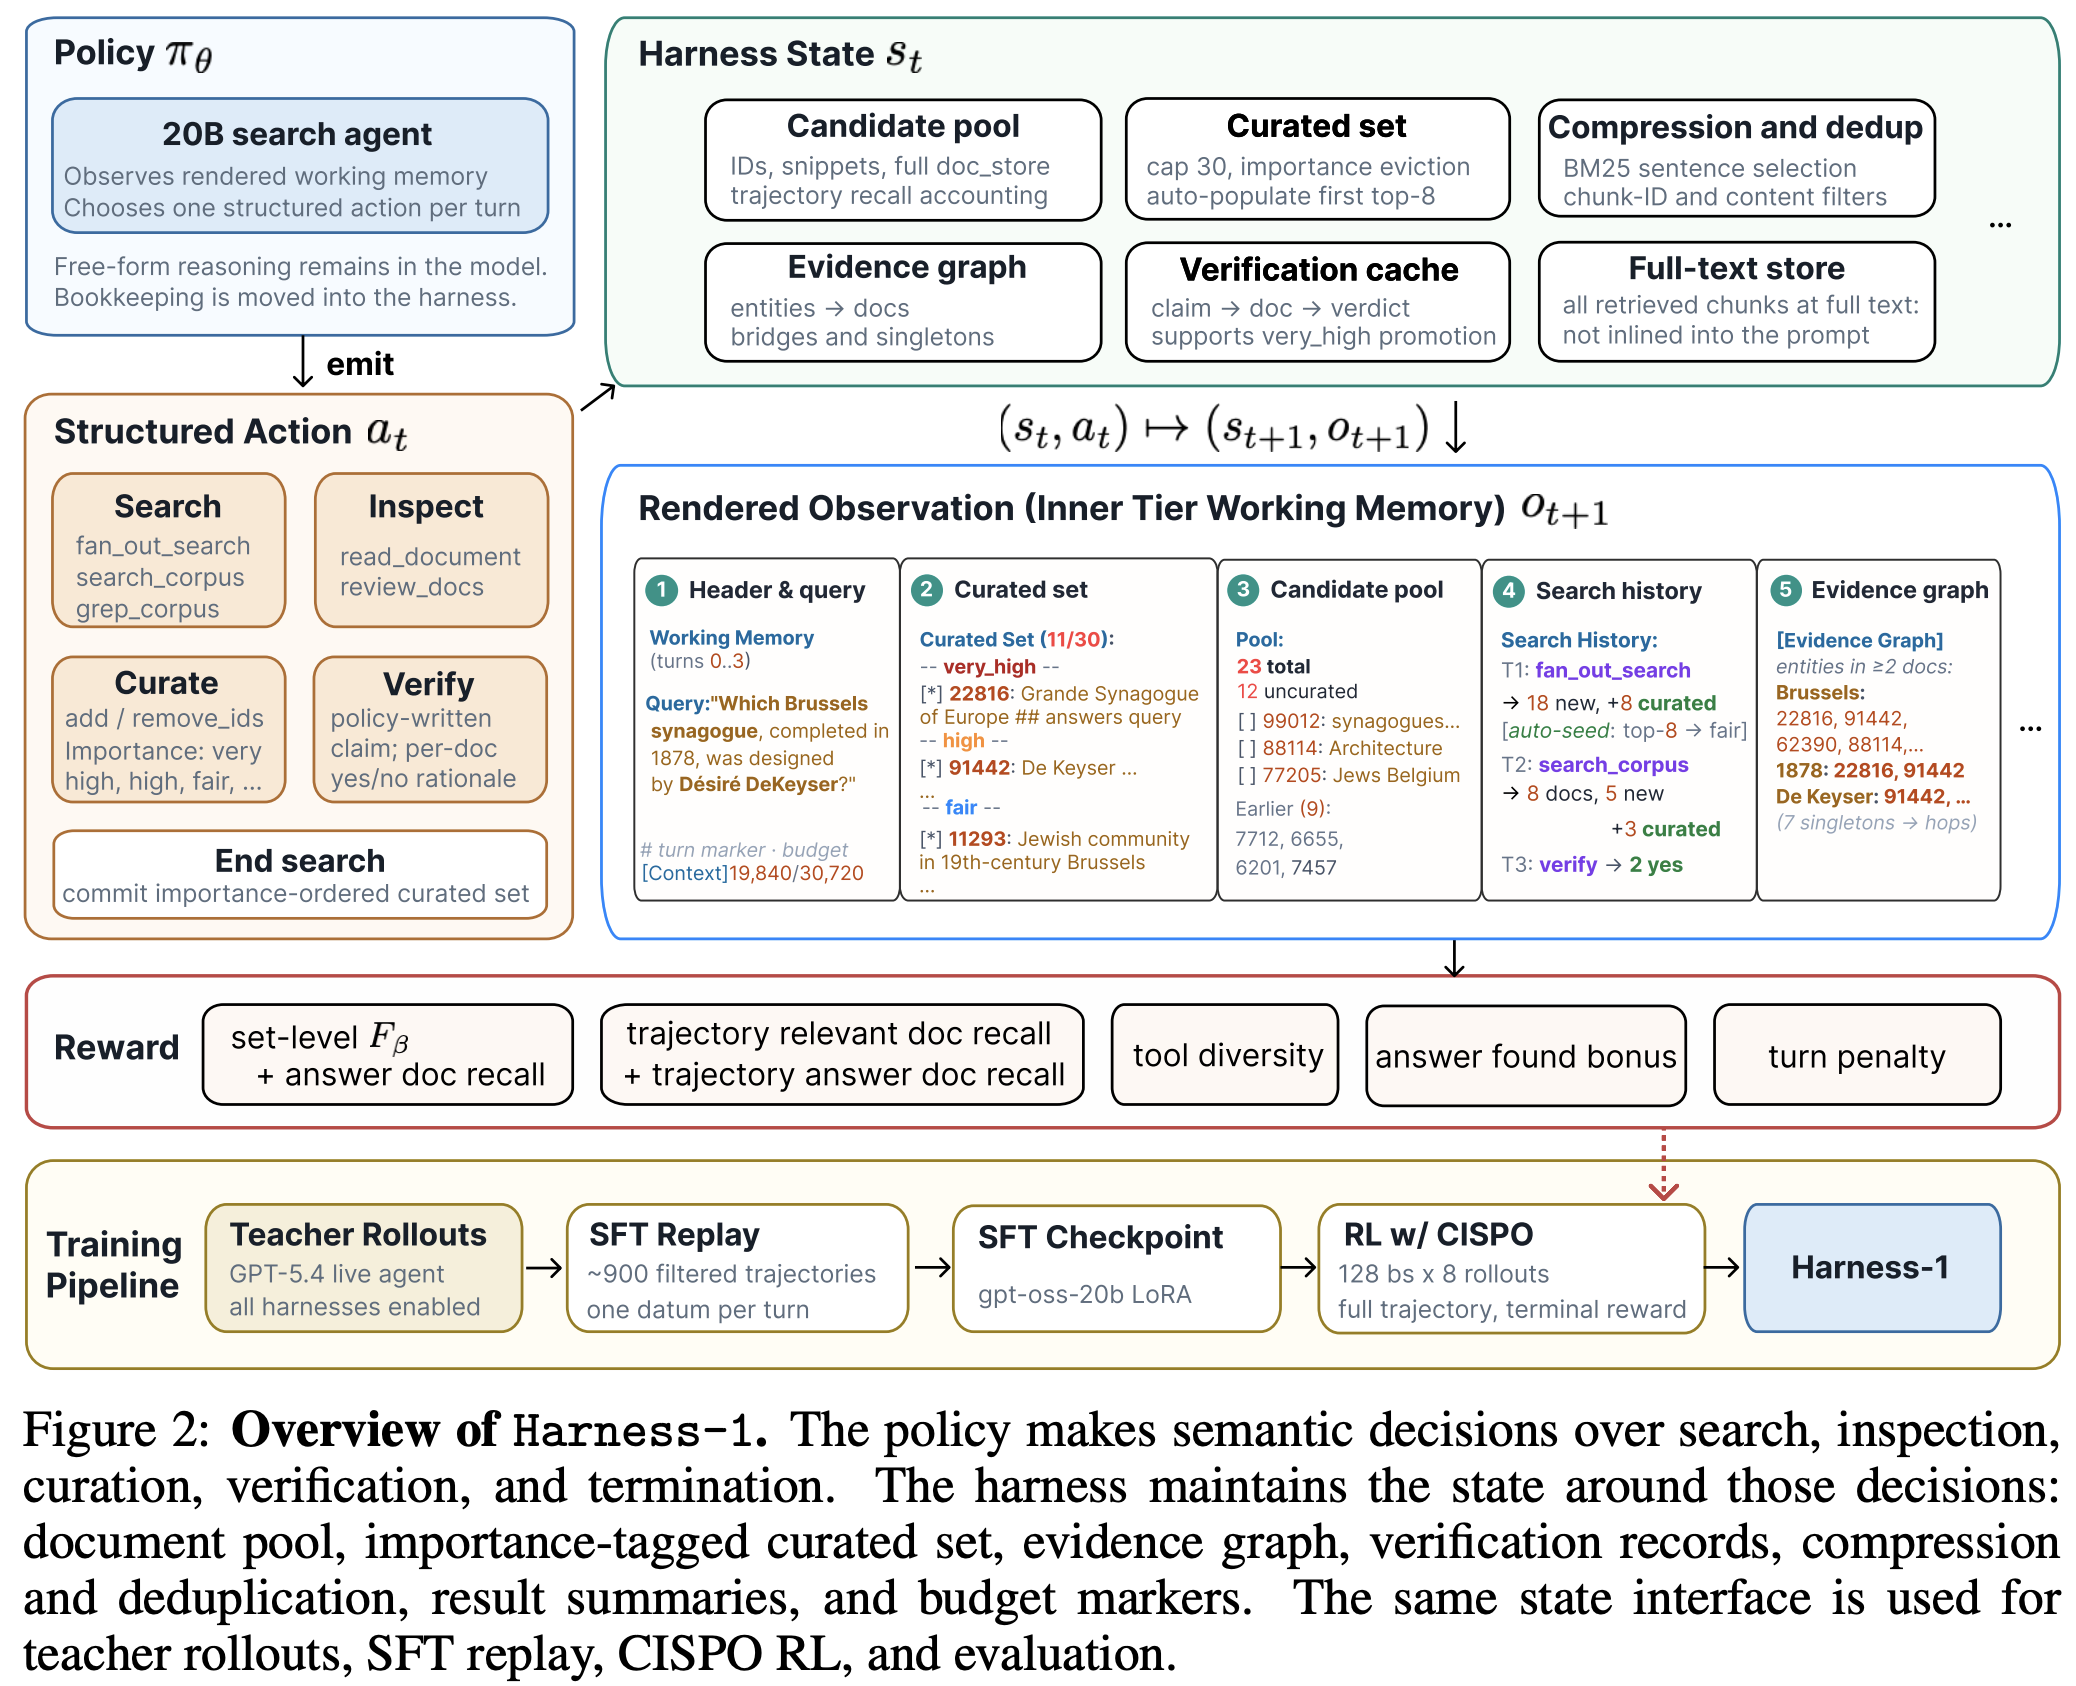
[정책 = 훈련되는 20B LLM] ↓ 행동(action) 출력 [하네스 = 규칙 기반 코드] ├─ 대부분: 순수 알고리즘/코드 (정렬, 정규식, 해시, 문자열 조합...) └─ 일부 도구 호출 시: 고정된(훈련 안 하는) 보조 모델 사용 ├─ verify → LLM 검증기 (고정) └─ 검색 결과 재정렬 → Qwen3-Reranker-8B (고정) ↓ 다음 관찰(observation) 렌더링 [정책이 다시 관찰을 보고 행동 결정]
Takeaway:
- Loss function
- S3논문
- Golden Dataset Curation: How? KG <--> BFS from A to FL lcoation // count number of common set of files (crashstack & BFS candidates)
0. Abstract
검색 에이전트: 계속 늘어나는 대화 기록(transcript) 및 정책(policy)으로 훈련된다.
모델은 어떻게 검색할지를 결정해야 할 뿐만 아니라, 지금까지 무엇을 봤는지, 어떤 증거가 유용한지, 어떤 제약 조건이 아직 해소되지 않았는지, 그리고 어떤 주장이 실제로 검증되었는지까지 기억해야 한다.
--> 정책 내부에 너무 많은 일상적인 상태 관리(routine state management)해야한다고 주장. 이러한 강화학습은 의미론적인 검색 결정과, 환경이 더 안정적으로 유지할 수 있는 복구 역량 작업을 동시에 최적화하도록 강요받고 있는 셈.
상태를 유지하는(stateful) 검색 하니스: 강화학습으로 훈련된 20B검색 에이전트(검색 서브에이전트)인 Harness-1을 소개
Harness-1: 환경 쪽 작업 기억(working memory)을 유지
candidate pool
중요도가 태그된 큐레이션 세트(importance-tagged curated set)
compact evidence link
검증 기록
압축,중복제거된 관찰(observation)
예산을 고려한 컨텍스트 렌더링
정책 모델은: 무엇을 검색할지, 어떤 문서를 유지하거나 버릴지, 무엇을 검증할지, 언제 멈출지 결정 함.
1. Introduction
1.1 문제제기
검색 에이전트의 일반적 정의: 검색 도구를 호출하는 언어 모델.
질문 --> 쿼리 --> 증거 읽기 --> 부족한 부분 판단 --> 문서 반환.
이 관점은 ReAct 스타일 에이전트, 반복적 검색, 능동적 검색, 도구 훈련, 연구 흐름을 따름.
하지만 한계가 있음: 에이전트의 "눈에 보이는 행동"만 포착하고, 그 과정에서 필수적으로 구축되는 "검색 상태(search state)"는 놓친다.
성공적인 멀티턴 검색 에피소드가 기억해야 하는 것: (검색 상태)
어떤 문서를 봤는지
어떤 후보가 유지할 만한지
어떤 제약 조건이 아직 안 풀렸는지
어떤 엔티티가 서로 다른 증거 조각들을 연결하는지
어떤 주장이 원문과 대조하여 실제로 검증되었는지
1.2 강화학습에서 더 악화
최근 연구들이 보여준 것: LLM이검색과 상호작용하도록 RL로 훈련되어 쿼리 생성, 멀티턴 검색, 하위 검색 효용을 향상시킬 수 있음.
--> 그러나 대부분의 검색-에이전트 훈련은 모델에게 두 가지 다른 것을 동시에 학습시킴:
의미론적 검색 행동 (이해 판단): 지금 이 질문에 답하려면 다음에 뭘 검색해야 하는가, 이 문서가 답에 정말 도움이 되는가, 버려야 하는가, 이 주장이 맞는지 검증해야 하는가, 이제 증거가 충분하니 검색을 멈춰야 하는가
일상적인 상태 관리 (기록 관리): 지금까지 어떤 문서를 읽었는지 목록으로 남기기, 중복된 검색 결과를 걸러내기, 검증했던 주장들을 어딘가에 기록해두기,
대화 기록이 길어질 때 생기는 구체적 문제들:
정책이 관찰(raw observation)로부터 유용한 검색 상태를 매번 재구성해야 함 --> 비효율적, 학습에서 비효율적
비효율적인 이유: raw observation을 보고, 어떤 trajectory가 유용한지, (예, 중복된 정보가 (A,C)이니까 하나 무시한다), 하는것을 매번 policy모델이 판단해야함.
학습에서 비효율적: 행동 A를 했더니 보상이 좋았다/나빴다 --> 이러한 신호로 학습. 허나,원본 텍스트에서 상태를 재구성하는 과정 자체가 매번 조금씩 다르게 진행될 수있다(같은 정보라도 표현이 다르거나, 일부를 놓치거나).
같은 상황인데도 모델이 매번 다른 방식으로 상태를 "복원"하게 되어, 입력이 불안정해짐
그 결과 "이 행동이 좋은 결과로 이어졌다"는 인과관계를 학습 신호가 명확하게 잡아내기 어려워짐
즉, 모델이 배워야 할 것(검색 판단)과 별개로, 상태를 재구성하는 잡음까지 학습 신호에 섞여 들어가서 학습이 불안정하고 비효율적으로 됨
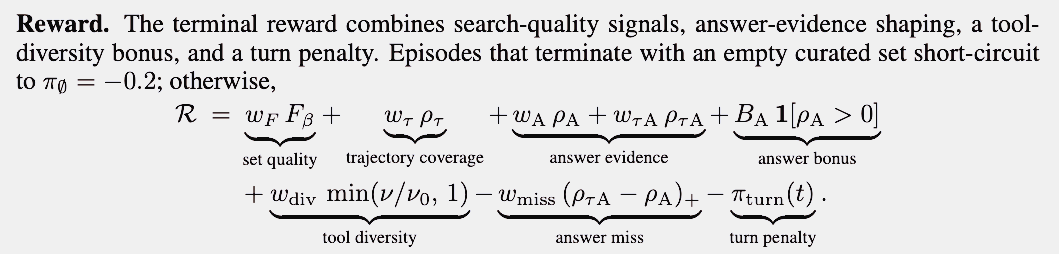
어려운 쿼리는 롤아웃마다 거의 동일한 빈 집합(empty-set) 보상만 받음 --> 모든 롤아웃이 같은 결과 (다 실패)
도구가 많아지면 반복적인 검색 호출로 붕괴 가능: 학습이 잘 안될 경우 같은 tool calling만 하게 됨 (이건 reward를 수정할 필요가 있겠음). 검색을 계속하면 최소한 보상이 0보다는 나을 확률이 있으니, 모델이 "안전한 선택"으로만 몰림
문서 간 구조(cross-document structure)가 대화 기록에 존재해도 너무 여기저기 분산되어 활용 불가: n-hop이 필요한 복잡한 과정이 있는 것은, trajectory가 길어지면 linking을 잘 못 함.
최종 큐레이션 세트가 비었거나 잘못됐을 때, 보상이 실패 원인을 구분 못함 (잘못된 검색 vs 잊혀진 증거 vs 빠진 검증 vs 부실한 큐레이션): 대부분의 보상은 최종 답변으로 1/0으로 주어짐. 그래서 검색을 잘 하여 증거를 잘 찾았으나, 다음 에피소드에서 검색 역량이 업데이트 될 수 있음.
1.3 해결 방안: 상태 인지 오프로딩
역할 분담 제안:
정책: 명시적 검색 상태에 대해 의미론적 결정만 담당(무엇을 검색할지/유지할지/검증할지/언제 멈출지)
하니스: 그 결정을 둘러싼 복구 가능한 상태를 유지 (후보 풀, 큐레이션된 증거, 문서 간 링크, 검증 기록, 컨텍스트 예산)
--> RL에게 검색 행동을 개선할 안정적인 인터페이스를 제공하며, 모델이 추가 전용(append-only) trajectory에서 증거를 매번 재발견하도록 요구하지 않음.
1.4 관련 연구
선행 연구(에이전트-컴퓨터 인터페이스, 소프트웨어 엔지니어링 에이전트): 언어 모델을 둘러싼 인터페이스가 행동과 성능에 영향을 끼침을 보임
최근 검색 시스템들: 컨텍스트 관리를 검색 과정의 일부로 다루기 시작 (컨텍스트 프루닝, 자기 편집 검색 등)
Harness-1의 차별점: 이 인터페이스 자체가 방법론의 일부. 에이전트는 환경이 유지하는 지속적인 검색 상태 위에서 행동하고, 매 관찰마다 그 상태가 정책에게 다시 렌더링됨.
1.5 풍부한 하니스만으로 부족 --> 3가지 훈련 요건 필요
문제점:
모든 롤아웃이 빈 큐레이션 세트로 시작 --> 초기 보상들이 서로 구별 안 됨
파생 상태가 너무 장황 --> 증거, 컨텍스트 공간을 두고 경쟁
보상이 오직 발견(discovery)만 중시 --> 정책이 큐레이션, 검증 무시하고 반복적인 검색 툴링에 수렴함
해결을 위한 3가지 요구사항:
웜스타트 큐레이션(warm-started curation): 성공적 검색으로부터 임시 큐레이션 세트 자동 시딩 (SEC 데이터셋)
압축된 파생 상태 렌더링(compact derived-state rendering): 중요도 태그, 증거 그래프 요약, 검증 기록으로 구현
다양성 보존 인센티브(diversity-preserving incentives): 검색,큐레이션,리뷰,검증의 다양성 장려
2. Take) Harness-1
Harness-1은 필요한 문서를 모으는 검색 에이전트다. 이 에이전트는 에피소드별 WORKINGMEMORY를 중심으로 state-machine 하니스 안에서 동작.
매 턴마다 하니스는 압축된 검색 상태를최근 행동,관찰과 함께 렌더링하고, 모델은 하나의 구조화된 Harmony 행동을 내놓으며, 하니스는 그 행동을 실행하고 상태를 갱신한 뒤 다음 관찰을 렌더링한다
Harmony는 OpenAI가 gpt-oss 모델 계열을 위해 만든 대화/도구 호출 포맷(형식)
다른 에이전트: 단순히 trajectory를 append -- 정리되어 있지 않음. 따라서 policy가 정보를 소비하는데 어려움이 있음.
Harness-1: 정보를 한번 가공해서, policy모델이 크게 생각을 안해도 소비할 수 있게 만들어 놓음.
WorkingMemory: 두개 계층으로 구성 -- 안쪽 층(프롬프트에 바로 보이는 부분), 바깥 층(필요할 떄 꺼내 씀)
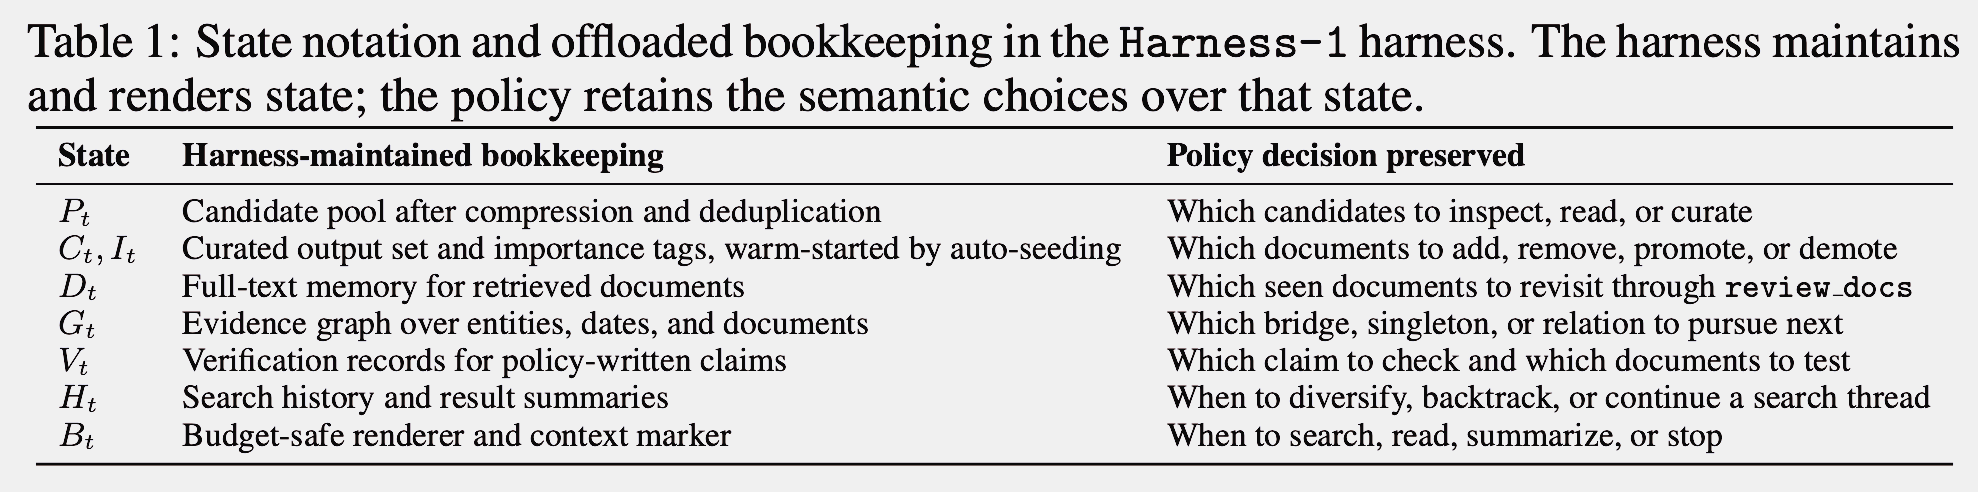
Policy모델이 볼 안쪽 계층: 압축된 정보인 $P_t$, $C_t$, $I_t$, $G_t$, $V_t$, $H_t$, $B_t$
P: 후보 문서 풀
C: 큐레이션셋, 최종 출력
I: 중요도 태크
D: 전체 원문 저장소
G: 증거 그래프
V: 검증 기록
H: 검색 이력
바깥 층: $D_t$
따라서 프롬프트에는 전체 문장이 들어가는게 아니라, 압축된 정보들이 들어가고 필요에 의하여 원문을 저장하는 $D_t$에서 필요 정보를 불러올 수 있음.
2.1 Policy actions as edits over working memory
Harness-1은 5가지 액션을 한다
검색
메모리 검사: 찾은 문서를 재검색 없이 다시 살펴보기
큐레이션: 최종 문서 목록에 추가/제거, 중요도 태그 붙이기
검증: AI가 만든 주장이 실제 문서 내용과 맞는지 확인
종료: 최종 문서 목록 제출 및 끝내기
Retrieval: 출력은 단순히 프롬프트에 덧붙여지지 않고, 압축과 중복제거를 거친 후, 후보 풀 $P_t$와 저장소 $D_t$를 갱신한다.
fan out search: 최대 5개의 다양한 쿼리를 병렬로 실행
search corpus: 쿼리 하나로 목표를 좁혀서 검색
grep corpus: 정규식으로 정확한 문자 매칭
read document: 알고있는 문서 ID 전체 원문 가져오기
Curation: 상태 직접 편집
최종 문서 목록에 추가할 문서, 제거할 문서, 중요도 태그를 한 번에 지정
중요도는 4단계: 매우 높음 / 높음 / 보통 / 낮음
최종 목록은 최대 30개까지만 담김 → 꽉 차면 가장 낮은 중요도 문서부터 자동으로 밀려남
AI는 "확신도 표현"만 하면 되고, 용량 제한 같은 번거로운 관리는 시스템이 알아서 처리
Auto-Seeding:
문제 상황: 목록이 텅 빈 채로 시작하면, 어려운 질문에서는 초반 시도 대부분이 "빈 결과"로 끝나서 AI가 배울 게 없음
해결: 에피소드가 시작되고 AI가 처음으로 검색을 실행 --> 그리고 그 검색이 성공할 경우
search_corpus, fan_out_search --> 검색 결과가 나오면 (검색 결과가 없는 경우가 많음.)
상위 8개가 문서로 등록, AI가 아무것도 하지 않아도 등록됨. fair등급으로 넣어줌.
이후에 AI가 스스로 판단해서, 좋은건 냅두고 나쁜건 뺌.
효과: AI가 풀어야 할 문제가 "0부터 목록 만들기"에서 "이미 있는 초안을 다듬기"로 바뀜
주의할 점: 이게 AI 대신 "이 문서가 관련 있다"고 판단해주는 건 아님 — 그냥 시작점을 잡아줄 뿐, 강한 문서를 승급시키고 약한 문서를 빼는 건 여전히 AI의 몫
Verify and memory review
verify: AI가 "이런 주장이 맞다"라고 문장을 쓰면, 하네스가 저장된 문서 원문과 대조해서 참/거짓 판정과 근거를 자동으로 기록 → "뭘 검증할지"는 AI가 정하고, "실제로 맞는지 대조하는 기계적 작업"은 하네스가 함
review_docs: 이미 본 문서를 새로 검색하지 않고 다시 꺼내서 보여줌 → 승급/강등/제거/검증하기 전에 재확인하는 용도
2.2 Derived-state rendering: evidence graph, compression, and deduplication
하네스는 단순히 텍스트를 저장하는게 아니라, 검색 기록에서 압축된 정보를 뽑아내서 LLM에게 보여줌
목적: 도구가 얻은 날것의 정보를 보여주는게 아니라 한번 가공된 상태를 보게 하는게 목적임.
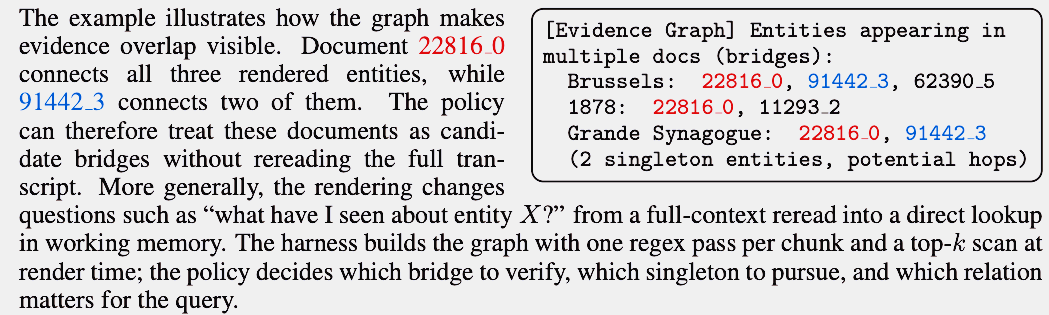
Evidence Graph:
새롭게 들어오는 문서마다 정규식으로 3가지 정보를 자동으로 추출함.
여러 단어로 된 고유명사
4자리 연도/연대
숫자로 된 날짜
이것으로 어떤 엔티티가 어떤 문서들에서 등장하는지 지도를 만들고, 다음 표시함
빈출 엔티티: 여러 문서에 걸쳐 자주 등장하는 것
브릿지 문서: 빈출 엔티티를 2개 이상 포함한 문서 --> 검증하거나 중요도를 올릴 유력 후보
단독 엔티티: 딱 하나의 문서에만 등장 --> 다음 검색 단어로 활용 가능
효과: append하면, 그 사이에서 추론을 해야하는데, think token을 소비하면 가능 할 수 있겠으나 쉽지는 않음. 전체 기록을 처음부터 다시 읽는 일에서 작업 기억을 한 번 훑어보는 일로 바뀜
이 그래프는 문서 하나당 정규식 한 번, 렌더링할 때 상위권만 훑는 정도로 가볍게 만들어짐 — 어떤 브릿지를 검증할지, 어떤 단독 엔티티를 파고들지는 여전히 Agent가 결정
예시)
Brussels는 5곳의 문서에 나옴 // 1878은 두곳에 등장. // Grande Synagogue도 두곳 등장
문서 91442는 그 중 Brussels, Grande Synagogue 를 연결
유용성:
LLM은 이 표만 보고도 22816 ~ 91442가 서로 다른 단서를 이어주는 핵심 문서이구나를 바로 알 수 있음.
이 그래프를 만드는 비용도 매우 저렴함.
어떤 문서를 검증할지, 어떤 엔티티를 따라가 볼지, 어떤 관계가 이 질문에 중요한지 같은 최종 판단은 여전히 정책 모델이 진행함.
Result summaries and budget markers.
검색/조회 행동이 끝날 때마다: 어떤 도구를 썼는지, 몇 개 문서를 새로 찾았는지, 목록이 어떻게 바뀌었는지, 남은 컨텍스트 예산이 얼마인지 자동 기록
LLM은 "지금 얼마나 진행됐고 얼마나 여유가 남았는지"를 명시적으로 확인 가능
BM25: 검색 결과가 너무 길면 컨텍스트를 다 잡아먹어서, 쿼리와 관련있는 문장 4개만 골라서 원래 순서대로 보여줌. 단, read_document로 명시적 요청하면 원문 그대로 반환
아래 내용은 Policy가 직접 다루지 않아도 되는것, 환경이 자동으로 대신 기억해줌. P (후보 문서 풀) = 빈 목록 C (큐레이션셋, 최종 출력) = 빈 목록 I (중요도 태그) = 빈 목록 D (전체 원문 저장소) = 빈 목록 G (증거 그래프) = 빈 그래프 V (검증 기록) = 빈 목록 H (검색 이력) = 빈 목록 AUTOSEEDED = False (아직 자동 시딩 안 함)
정책이 첫 Turn에 보는 프롬프트 == Working Memory (turn 0) == Query: 경구 30kg 10세 금기 메스꺼움 반감기 10시간 미만 간 대사 2022 연구
Curated Set (0/30): (비어있음) Document pool: (비어있음) Search history: (비어있음)
정책의 첫 행동 -- 검색 {"tool": "search_corpus", "params": {"query": "경구 30kg 10세 금기 메스꺼움 반감기 10시간 미만 간 대사 2022 연구"}}
하네스가 검색 결과 처리: 검색 결과로 raw문서들이 여러개가 들어옴. 하네스가 이것을 처리함. 아래 순서대로 수행
문장 압축 (BM25): 원래 쿼리와 관련있는 상위 4개 문장만 남기고 나머지 버리고, 순서는 원문 그대로 유지함.
중복 제거: 같은 청크 ID가 이미 P에 있으면 스킵함. 청크 ID는 다르지만 내용이 거의 같으면, MinHash-LSH알고리즘으로 탐지해서 화면에 숨김. --> 왜이렇게 하냐면 이 문서를 봤었다는 점수 계산을 하기 위해서임.
새 문서를 P와 D에 저장: 전체원문은 D에 저장, P에는 짧은 요약본 저장 - 2단 계층 메모리가 이것을 의미함.
엔티티 추출 -- 새로 들어온 청크를 정규식으로 스캔 --> 대문자로 시작하는 고유 명사, 4자리 연도, 날짜 형식을 뽑아냄. 엔티티로 등록하고, 이 엔티티가 어느 문서에 등장했는지 업데이트
자동 시딩 (첫 검색에서만 발생): 모두 fair등급을 받음
Turn1: 정책이 큐레이션 행동을 함
자동 시딩된 8개 중에서 진짜 관련 있어 보이는 것을 골라 등급을 올림. {"tool": "curate", "params": { "add_ids": ["doc_17183", "doc_25814"], "remove_ids": [], "importance": {"doc_17183": "high", "doc_25814": "high"} }}
여기서 하네스가 하는 일:
remove_ids에 있는 문서는 C에서 제거
add_ids의 각문서에 대해서:
C에 있으면 --> 등급만 재 태깅
C가 아직 30개 미만 --> 그냥 추가
C가 30개 찼으면 --> C안에서 가장 낮은 문서 찾아, 새 문서 등급이 높으면 교체
Turn2~5: 검색 반복하며 다른 단서를 좁혀감
Turn6~8: 검색(grep)이 실패하는 경우: 검색이력 H에 저장함. 이 패턴으로 grep시도 했는데 0건이 나왔다. 이 기록을 보고 다음 turn에 다른 접근을 시도함. Turn9~10: 다른 각도로 검색 Turn12: 전체 원문 읽기 - read_document -- 지금까지는 압축된 문장4개만 봤음. 보고싶은 전체 문서를 봄. Turn13: 최종 확정: end_search 호출시 큐레이션 셋 C가 최종 결과로 제출됨.
2.3 Training: SFT and RL
앞에서 봤든 하네스는 LLM은 판단, 시스템은 잡일을 함. 훈련도 같은 원칙을 따라감. SFT는 인터페이스 사용법을, RL은 검색 실력 자체를 가르침.
SFT for harness operation
원래 SFT라면 "검색을 잘하는 법" 전부를 가르쳐야 할 것 같지만, 여기선 그럴 필요가 없음
이유: 하네스가 이미 부가(기록 정리) 작업을 대신 해주고 있기 때문에, LLM에게 가르쳐야 할 건 딱 인터페이스 사용법 정도로 충분함
구체적으로 가르치는 것 4가지:
도구를 부르는 형식 (포맷)
검색 → 큐레이션을 번갈아 하는 리듬
중요도 태그를 성실하게 붙이는 습관
확신 있게 문서를 "매우 높음"으로 승급시키기 전에 반드시 검증하는 규범
Take) 데이터는 어떻게 만드는가?
강한 모델(GPT-5.4)을 Teacher로 사용
GPT-5.4가 Harness-1라고 가정하고 동일한 일을함.
턴마다 힌트를 줘서 좋은 습관을 유도함: 검색했으면 큐레이션해라, 성과 없는 검색을 했으면 다른 방향으로 되돌아가라(백트래킹), 목록이 충분해지면 일찍 끝내라 등
이렇게 만들어진 궤적 중 형식이 맞고, 문서를 최소 1개 이상 반환했고, 최종 recall이 0.10 이상인 것만 남김 (성과가 너무 안 좋은 궤적은 버림)
턴마다 힌트를 줌: 사람이 실시간으로 개입하는 게 아니라, 정해진 규칙에 따라 자동으로 뜨는 시스템 메시지
예): Teacher가 검색을 하고나서 큐레이션(문서 채택)을 안 하고 또 검색만 하려고 한다면
하네스가 [ACTION REQUIRED]:검색 후에는 먼저 큐레이션하세요 같은 메시지를 자동으로 보여줌
예): 최근 검색 3번이 새로운 문서를 거의 못 찾음 (효율이 안 나옴) → 하네스가 [WARN] 메시지로 "이 방향은 성과가 없으니 다른 각도로 시도해보라"고 알림 → 이게 성과 없는 검색을 했으면 다른 방향으로 되돌아가라(백트래킹)는 힌트 → 실제 사례에서 볼 수 있는 예: 처음엔 정답 게임을 잘못된 것으로 판단해서 버렸다가, 나중에 다른 문서를 읽고서야 "아, 그게 맞았구나" 하고 되돌아가는 경우가 있었음
예): 목록이 이미 충분히 채워졌고 정답이 될만한 문서들이 잘 갖춰짐 → [TIP] 또는 [NEXT] 메시지로 "이제 그만해도 될 것 같다"는 뉘앙스의 알림 → 이게 "목록이 충분해지면 일찍 끝내라"는 힌트
형식이 맞고, 문서 1개 이상, Recall 0.1 이상인 것 남김 -- 좋은 trajectory만 선별
형식이 유효함 -- 도구 호출 문법이 깨지지 않고 제대로 됨
최소 1개 이상 반환 -- 최종 목록이 완전히 빈 채로 끝나지 않음
최종 recall 0.1이상 -- 정답 문서 중 최소 10%는 찾아냄
데이터 수: 899개 Trajectory수집 --> 그리고 펼쳐서 SFT수행
RL over full search episodes
SFT끝난 체크포인트에서 시작
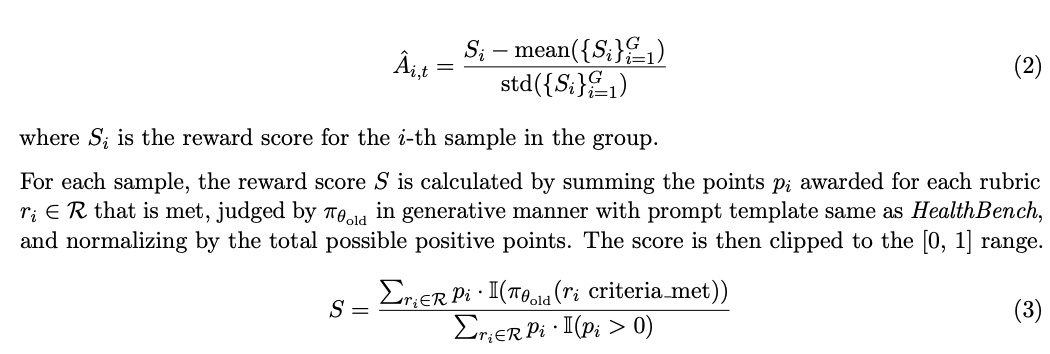
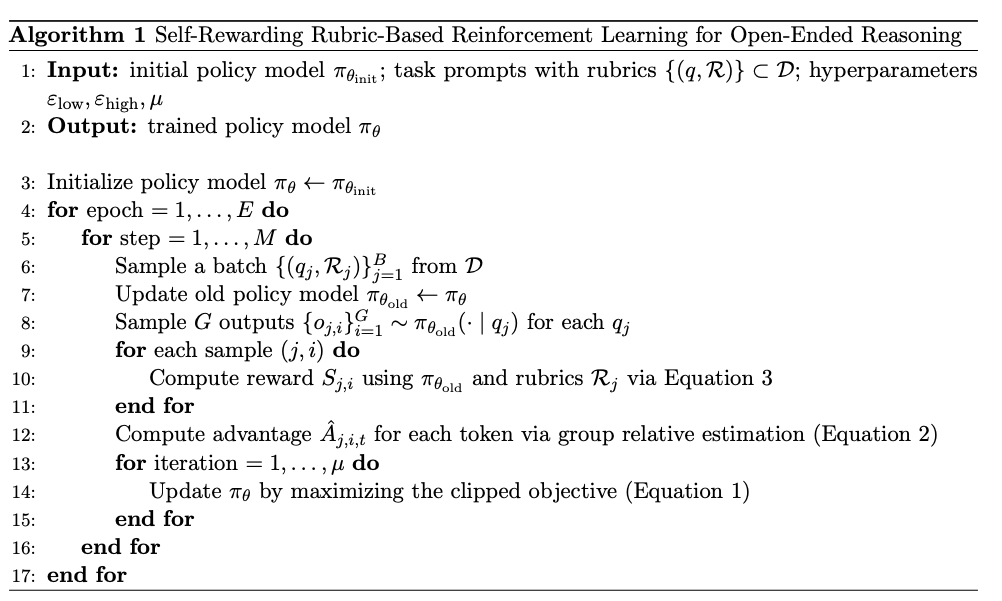
CISPO라는 on-policy 알고리즘 사용 - 같은 그룹 내 상대적 성과로 정규화 (그룹 advantage normalization)
GRPO와 차이점
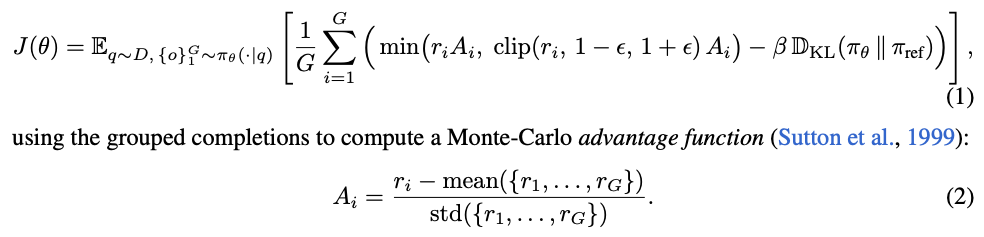
GRPO: 각 토큰을 (지금 정책이 낼 확률) / (예전 정책이 이 단어를 낼 확률) 비율이 너무 크거나 작으면 0.8, 1.2로 클립핑을 했음. 근데 이 클립핑 범위를 벗어나면 그래디언트가 0이 되어버림. --> 학습에 무시됨. 근데 이 토큰이 하필 However, aha와 같은거라면..? 중요한것을 배우지 못함. -E[ min( ~~, clip) ]
정말 날카로운 제안이에요. 사실 이건 논문이 부록 P에서 부분적으로 이미 검증한 방향이기도 해요. 정리해서 설명드릴게요.
💡 이 아이디어는 논문 데이터로 뒷받침됨
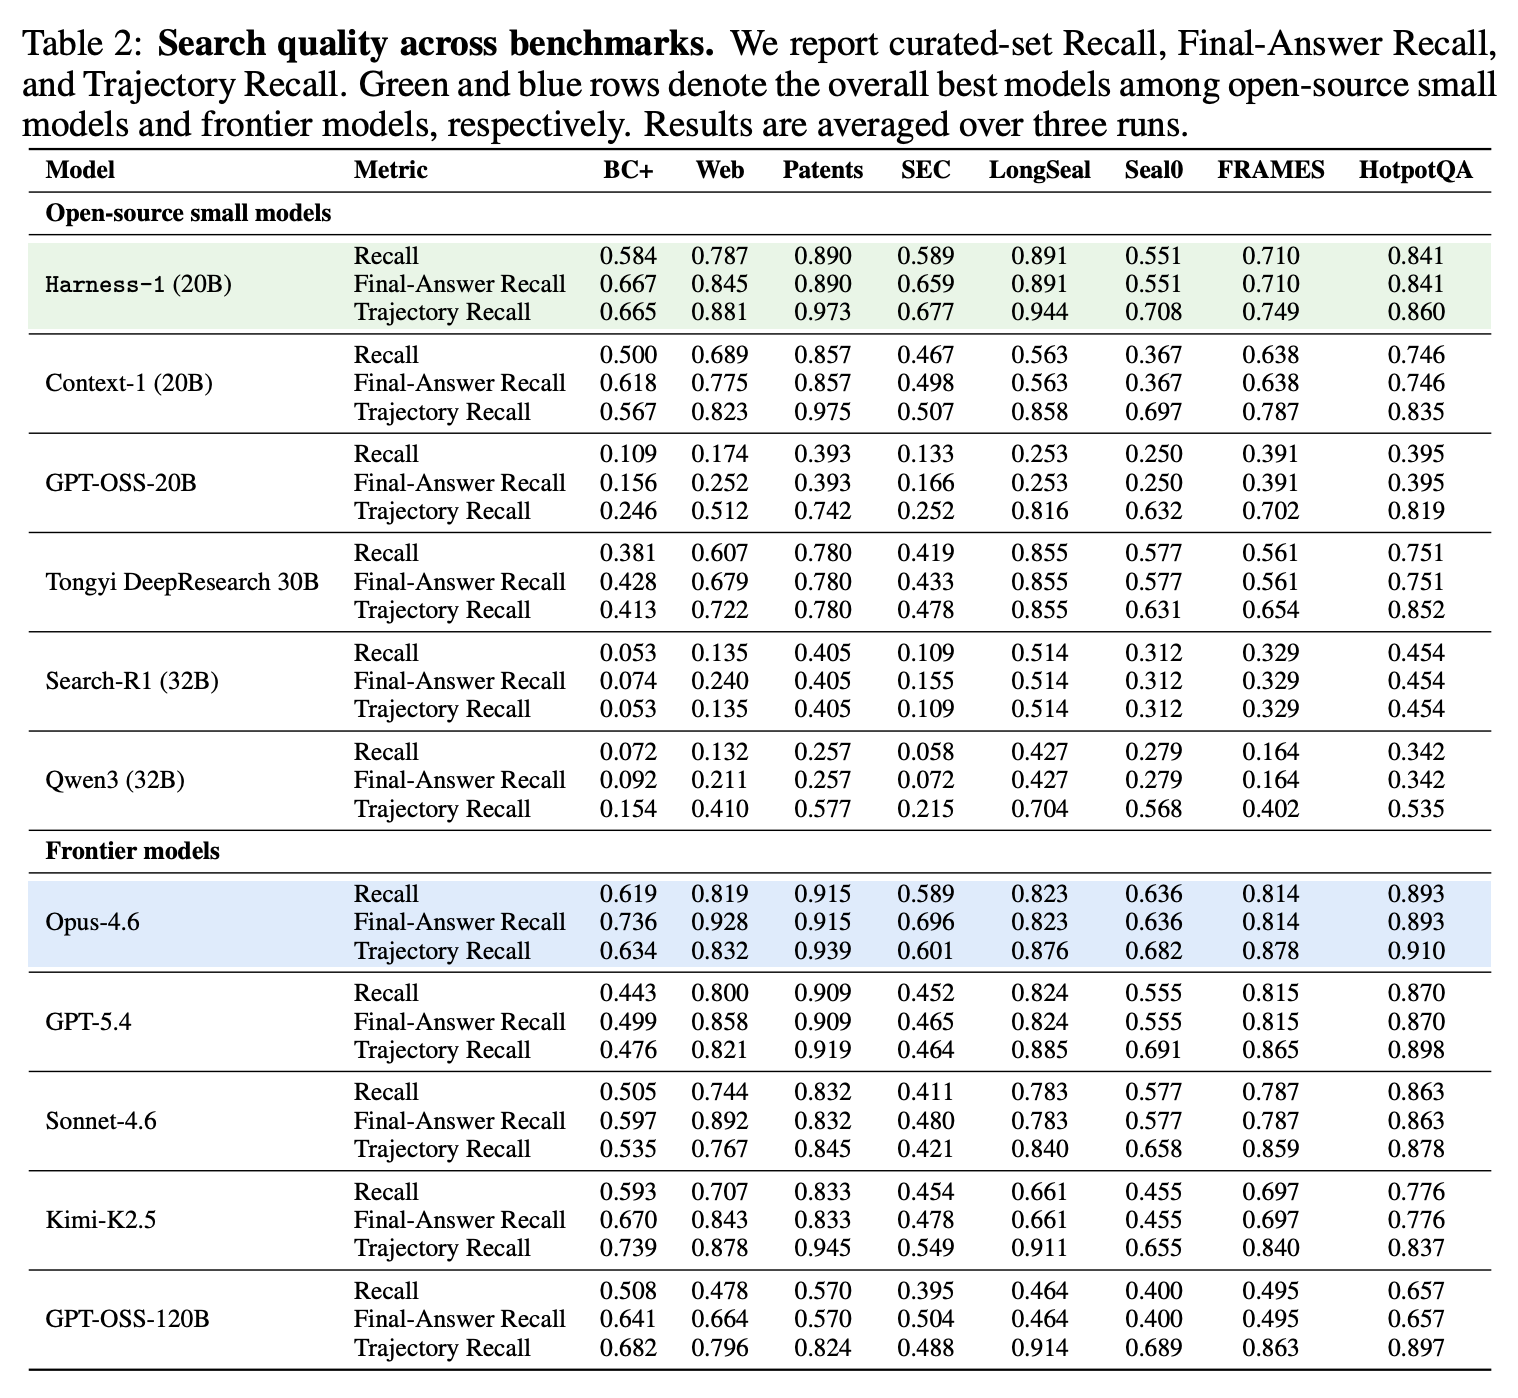
부록 P 실험을 보면: GPT-5.4를 하나도 훈련시키지 않고, 하네스만 바꿔가며(naive → Context-1 → Harness-1) 씌웠더니 curated recall이 0.511 → 0.807 → 0.849로 계속 올라감
즉 "모델은 그대로 두고, 상태 관리/큐레이션 로직만 좋아져도 성능이 크게 오른다"는 게 이미 증명돼 있음
제안하신 방향은 여기서 한 걸음 더 나아가는 것 — "하네스 로직을 규칙 기반으로 고정하지 말고, 큐레이션 판단 자체를 별도로 훈련시킨 작은 모델에게 맡기자"는 거죠
🏗️ 구체적으로 어떤 구조가 될까
[Opus/GPT-5.4 = 고정, 검색·읽기·추론 담당]
        ↓ 후보 문서, 검색 과정, 증거 그래프 등 원시 정보 생성
[작은 훈련된 큐레이터 모델 = 이것만 RL/SFT로 훈련]
        ↓ "이 문서를 넣을지 뺄지, 중요도는 얼마인지" 결정
[최종 큐레이션셋]
이건 사실 논문이 인용한 s3([16]번 참고문헌)의 아이디어와 거의 같아요 — s3는 "검색기(searcher)를 답변 생성기(generator)와 분리해서, 생성기는 고정한 채 검색 정책만 모듈적으로 최적화"함
여기서 제안하신 건 그 변형: "검색/추론은 프론티어 모델이 하고, 선별(curation)만 따로 훈련시키자"
✅ 왜 이게 매력적인가
Opus의 강력한 검색·추론 능력은 그대로 유지 — 어떤 쿼리를 던질지, 애매한 단서를 어떻게 해석할지 같은 고난도 판단은 이미 잘하는 프론티어 모델에게 맡김
훈련 대상이 훨씬 좁아짐 — 논문의 ablation 결과(Table 3)를 보면 중요도 태그, 자동 시딩 같은 큐레이션 관련 메커니즘만 따로 떼어도 FA recall이 6~8%씩 떨어짐. 즉 "큐레이션"이라는 스킬 하나만 잘 훈련해도 상당한 개선 여지가 있다는 뜻
비용 절감 — 프론티어 모델을 RL로 직접 파인튜닝하는 건 폐쇄 API에서는 사실상 불가능하거나(가능해도 매우 제한적), 매 스텝마다 대형 모델을 굴려야 해서 훈련 비용이 막대함. 반면 작은 큐레이터 모델은 값싸게 반복 훈련 가능
모듈형 RAG 프로토콜과 궁합이 좋음 — 이 논문이 이미 "고정된 답변 생성기 + 서로 다른 검색기의 큐레이션셋"을 비교하는 실험(부록 O)을 했는데, 이 구조를 그대로 "고정된 검색기(Opus) + 훈련된 큐레이터" 쪽으로 뒤집으면 됨
⚠️ 그래도 남는 문제들
데이터 큐레이션 문제가 사라지는 게 아니라 좁아질 뿐
큐레이터를 훈련하려면 여전히 "정답 문서가 뭔지" 라벨이 있어야 보상을 계산할 수 있음
다만 전체 검색 행동을 배우는 것보다 **"이미 후보로 올라온 문서들 중 뭘 남길지"**만 배우면 되니, 필요한 라벨링 범위와 탐색 공간이 훨씬 좁아짐 (풀어야 할 문제가 작아진 건 확실히 이득)
선별과 검색이 완전히 분리되지 않을 수 있음
논문 ablation에서 중요도 태그를 없애면, 정책이 검색 자체도 "넓고 얕은 모드"로 퇴행함 (search_corpus 비중 급증, verify/read 급감)
즉 "이 문서를 왜 검색했는지, 어떤 맥락에서 나왔는지"를 큐레이터가 모르면 제대로 판단하기 어려울 수 있음 → 큐레이터에게 검색 맥락(어떤 쿼리로 나왔는지, 증거그래프상 위치 등)을 충분히 넘겨줘야 하고, 이러면 "가볍게 떼어놓기"가 생각보다 안 가벼워질 수 있음
인터페이스 설계 문제
Opus가 큐레이터에게 후보를 어떻게 넘겨줄지(어떤 형식, 어떤 메타데이터 포함)를 프롬프트로 설계해야 하는데, 폐쇄 API는 내부 동작을 조정할 수 없어서 "Opus가 협조적으로 후보를 잘 넘겨주도록" 프롬프트 엔지니어링에 의존해야 함 → 완전한 제어권은 없음
비용/지연시간 트레이드오프
프론티어 모델 호출 + 별도 큐레이터 호출을 매 턴 반복하면, API 호출 수와 지연시간이 늘어날 수 있음 (다만 프론티어 모델을 재훈련하는 것보다는 훨씬 쌈)
🎯 결론적으로
말씀하신 방향은 **"프론티어 모델의 추론력은 사서 쓰고, 우리가 통제 가능한 부분(선별 로직)만 학습시킨다"**는 점에서 실용적으로 꽤 합리적이에요. 특히:
s3 논문이 이미 이 방향(검색기/생성기 분리 학습)의 유효성을 보여줬고
이 논문의 부록 P가 "하네스만 바꿔도 고정 모델 성능이 오른다"는 걸 실증했으니
"고정 모델 + 훈련된 큐레이터" 조합은 다음 단계로 시도해볼 만한 자연스러운 실험이에요. 다만 "데이터 라벨링 문제 자체가 사라지는 건 아니고, 풀어야 할 문제의 크기가 줄어드는 것"이라는 점, 그리고 "선별이 검색 맥락과 얼마나 분리 가능한가"는 실제로 실험해봐야 아는 열린 질문이라는 점은 염두에 두시면 좋을 것 같아요.
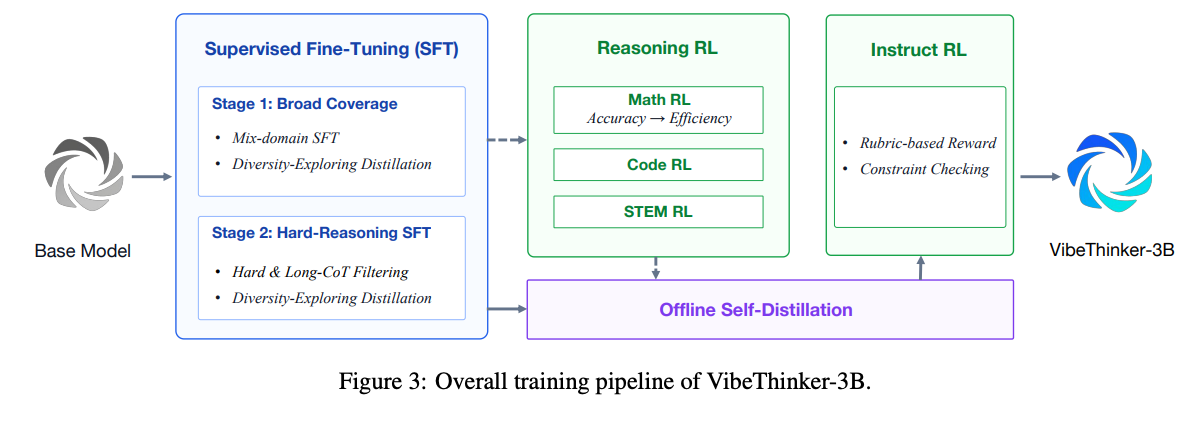
[Qwen2.5-Coder-3B 기본 모델] ↓ [Stage 1: SFT - 광범위 커버리지] 수학 + 코드 + STEM + 대화 + 지시 따르기 ↓ [Stage 2: SFT - 어려운 추론 집중] 긴 CoT, 고난도 문제만 선별 ↓ [Stage 3: Math RL → Code RL → STEM RL] 순차적 다영역 강화학습 ↓ [Stage 4: Long2Short RL] 정확도 유지하며 답변 길이 단축 ↓ [Stage 5: Offline Self-Distillation] 각 RL 단계 체크포인트에서 좋은 궤적 수집 ↓ [Stage 6: Instruct RL] 복잡한 지시 따르기 강화 ↓ [VibeThinker-3B 최종 모델]
Focus on the dataset with a difficulty level where the model gets it right only half the time
key takeaway:
Diversity-Exploring Distillation
MGPO
1. Introduction
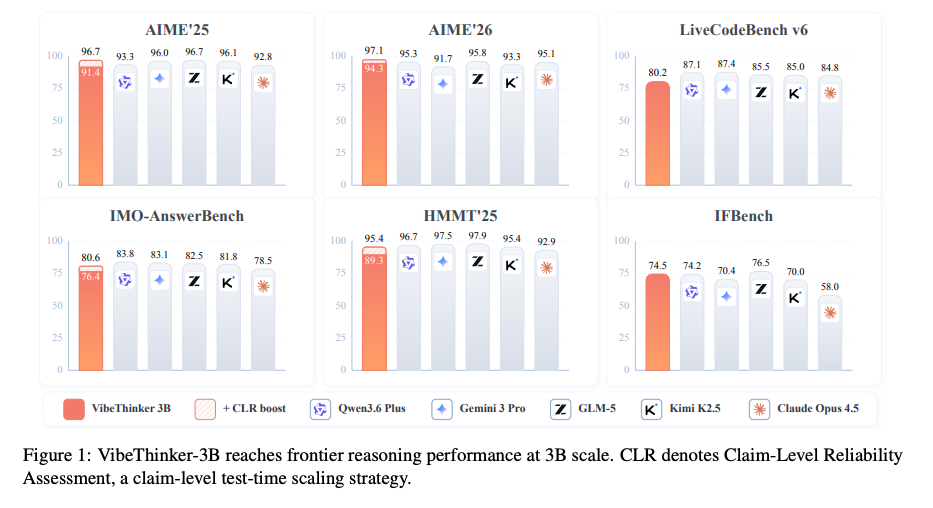
RL이 post-training에 사용되면서 LLM의 추론능력이 강화됨. 최고 성능의 추론 모델들은 수천억 파라미터를 가진 모델로, 추론능력은 여기에 집중됨. 30억개 이하의 SLM에서는 추론의 한계가 있다고 여겨졌다. 이전 연구 VibeThinker-1.5B에서는 기본적인 CoT생성하도록 할 수 있음을 보여주었다. 이는 소형 모델이 장기 추론에 어려움을 겪는다는 것을 반박하는 시도이다. 허나 성능의 상한선은 탐구되지 않았다. 과연 SLM의 성능적 한계는 어디인가?
이 논문에서는 1.5B 에서 제안한 Spectrum-to-Signal 원칙을 기반으로 파이프라인을 전면 개선함.
SFT 단계: 데이터 합성, 품질 필터링, 커리큘럼 학습을 강화 --> 수학, 코드, STEM, 일반 대화, 지시 따르기에 걸쳐 폭넓은 역량을 갖추게 하고, 난이도 높은 장기적 추론 샘플에 집중하도록 하였다.
RL 단계: MGPO의 핵심 아이디어를 유지, 훈련을 다양한 검증 가능한 도메인으로 확장, 더 안정적인 장문 컨텍스트 전략을 채택하여 완전한 추론 궤적을 보존. 또한 Long2Short Math RL을 새로 도입하여, 정확도를 희생하지 않으면서 불필요한 토큰을 줄여 추론 효율을 개선.
Offline Self-Distillation와 Instruct RL: 각 단계에서 이끌어낸 역량을 하나의 통합된 모델로 공고히 하고, 복잡하고 제약이 많은 사용자 지시를 따르는 능력을 향상.
다른 벤치는 점수가 높은데, GPQA-Diamond에서는 성능이 낮음 --> 파라미터 압축-커버리지 가설(Parametric Compression-Coverage Hypothesis)을 제안.
능력마다 파라미터가 필요한 이유가 다르다:
기존 통념: 파라미터가 많을수록 무조건 좋다 (양의 문제)
이 가설의 주장: 능력마다 파라미터가 필요한 구조적 형태가 다르다 (질의 문제)
파라미터 밀집형 (소형모델로 가능). 예) 수학 증명, 코딩, 논리 추론
핵심 과제가 사실 암기가 아님
대신 구조화된 공간 안에서 아래를 반복 수행: 풀이 경로 탐색, 제약 조건 충족, 오류 감지 및 수정, 여러 단계를 이어붙이는 합성
이 과정은 재사용 가능한 추론 패턴으로 압축 가능 → 파라미터가 적어도 그 패턴을 충분히 담을 수 있음
파라미터 확장형 (대형 모델 필요). 에) 백과사전 지식, 범용 대화, GPQA같은 지식
핵심과제가 광범위한 사실을 기억하는 것
다루어야 할 것들: 개방형 사실, 도메인별 전문 개념, 단어·개념 간 의미 연관성, 자주 등장하지 않는 롱테일 시나리오
압축이 아니라 커버리지의 문제 --> 파라미터 많을 수록 더 많은 지식 저장 가능
파생 제안: 추론-지식 분리 패러다임.
대형 모델의 역할: 넓은 지식을 저장하는 그릇 → 앞으로도 필요
소형 모델의 역할: 구조화된 문제에서 깊은 추론을 수행하는 엔진 → 새롭게 재정의
둘은 경쟁 관계가 아니라 역할이 다른 상호 보완 관계
2. Methods
전체 파이프라인: Qwen2.5-Coder-3B를 기반으로, Post-training함
목표: 데이터 합성, SFT, RL, self-distillation, instruction-oriented alignment
전체 프레임워크는 1.5B에서 소개한 Spectrum to signal principle을 따름.
SFT: Diversity-Exploring Distillation -- 광범위한 풀이 공간을 구성
SFT: 데이터 합성, 필터링이 더 엄격해짐. -- 광범위 능력을 확보하고 장기 추론 능력으로 자연스럽게 전환
RL: 다양한 영역에 MGPO적용.
Long2Short단계를 추가로 도입.
Offline self-distillation
Instruct RL: 복잡한 다단계 지시를 따름.
2.1 Supervised Fine-Tuning
2.1.1 Data Construction
다양한 영역에서 데이터셋 구성.
2.1.1.1 데이터셋 합성 및 쿼리 확장
데이터 필터링: 수학은 쿼리가 명확하고, 신뢰할 수 있는 최종 답 혹은 풀이가 있어야함 // 프로그램의 경우 유닛테스트, 실행 가능한 평가 기준있어야함.
파생 쿼리 작성: 비슷한 형태의 쿼리를 만들고, 라벨링은 강력한 모델을 여러번 사용해서 가장 많이 나온 답을 정답으로 채택함.
음.. 근데 필터링은 명확한 신호를 모델에 주기 위해서 필터링 했으면서, 파생 쿼리에서는 정확하지 않은 답을 주는게 말이 되나?
2.1.1.2 Multi-Path Reasoning Distillation
추론이 중요한 테스크 (수학, 코드) Multi-path reasoning distillation을 수행
강력한 모델로, 각 쿼리에 대해 여러 후보 추론 경로를 샘플링함.
최종 답만 보존하지 않고, 중간 추론 전체를 보존 (1.5B의 Spectrum to signal 패러다임)
이 reasoning path를 학습하여, RL에는 더욱 다양한 생각을 하도록 유도함.
2.1.1.3 Multi-level Quality Control
SFT 데이터 품질은, RL의 성능 상한을 직접적으로 결정함. 엄격한 다단계 품질 관리 프로세스를 도입함.
N-gram 기반 필터링: 비정상적인 반복 구간, 템플릿화된 퇴화 패턴, 혹은 Test 세트와의 n-gram 중복이 포함된 샘플을 제거하여 저품질 생성물과 벤치마크 오염을 방지한다.
LLM 기반 쿼리 품질 필터링: 강력한 LLM을 활용해 쿼리 품질을 평가 --> 설명이 불완전하거나 조건이 불합리하거나 논리가 유효하지 않은 샘플, 또는 목표 지식 포인트를 효과적으로 평가하지 못하는 샘플을 걸러낸다.
추론 경로 정확성 필터링: 증류된 응답 수준에서는 답 검증, 코드 샌드박스 실행, LLM 다수결 투표를 조합해 추론 경로를 검사한다. 최종 답이 틀리거나, 실행 결과가 실패하거나, 추론 단계가 명백히 유효하지 않은 경로는 제거한다.
2.1.2 Training Process
2.1.2.1 Curriculum-based two-stage SFT strategy
1단계: 콜드 스타트. 과제 유형 및 추론 패턴의 다양성을 최대화 하기 위해서 품질 필터링된 데이터셋으로 훈련. 훈련의 효율성을 높이기 위해서 배치내에서 패딩을 사용하지 않고, 시퀀스 패킹을 사용함. (배치 128, 학습률 코사인, 5%는 선형 워밍업, 5에폭)
2단계: 훈련 데이터 분포를 난이도가 높고, 장기적인 추론이 필요한 샘플로 학습을 전환. (길이, 난이도) 필터링을 통해 생성한 추론 서브셋으로 훈련을 이어감.
먼저 추론 경로가 5,000 토큰 미만인 샘플을 제거, Vibe1.5B를 참조 모델로 삼아 쿼리당 8회 롤아웃을 하고, 오답률이 0.75 미만인 쉬운 문제를 제거함. --> 장기적 논리를 학습하게 하기 위해서.
2에폭 추가 훈련
시퀀스 패킹
# 개념적 어텐션 마스크 (block-diagonal)
#         A      B      C      D
# A     [봄]   [못봄]  [못봄]  [못봄]
# B     [못봄]  [봄]    [못봄]  [못봄]
# C     [못봄]  [못봄]  [봄]    [못봄]
# D     [못봄]  [못봄]  [못봄]  [봄]
#
# 각 샘플은 자기 자신 내부만 어텐션 → 독립적인 샘플처럼 학습됨
# 하지만 물리적으로는 하나의 긴 시퀀스에 패킹되어 GPU 효율 극대화
2.1.2.2 Diversity-Exploring Distillation
Vibe1.5B, 두 SFT 단계 모두 다양성 탐색
그래디언트 간섭: 수학, 코드, STEM을 한 모델로 동시에 훈련하면 한 도메인이 다른 도메인 능력을 깎아 먹음.
훈련 시작: SFT 1,2 단계 시작
훈련 도중 체크포인트를 주기적으로 저장한다.
각 체크포인트를 도메인별 문제로 테스트한다. 이떄 기준점은 Pass@8로 평가함. 8번 sampling을 함.
도메인별로 가장 다양하게 잘 푸는 체크포인트를 고름
수학 전문가 = Pass@K가 가장 높은 체크포인트 (예: ckpt 3) 코드 전문가 = Pass@K가 가장 높은 체크포인트 (예: ckpt 2) STEM 전문가 = Pass@K가 가장 높은 체크포인트 (예: ckpt 4)
선택된 특정 모델들을 파라미터 단위로 병합한다. # 개념적 예시 (실제로는 더 정교한 병합 기법 사용) merged_weights = (math_expert_weights + code_expert_weights + stem_expert_weights) / 3
병합된 모델이 최종 SFT가 된다.
2.2 Reinforcement Learning
2.2.1 Algorithm Backbone
1.5B에서 소개한 MaxEnt-Guided Policy Optimization, MGPO를 RL알고리즘으로 사용함, 스펙트럼-투-시그널 원칙 하에서, RL은 올바른 추론 신호를 증폭하는 역할을 담당함. MGPO는 모델의 현재 능력 경계 근처에 있는 프롬프트를 동적으로 선택하여 이 역할을 수행함.
$D_{ME}(p(q)||p_o)$: 는 현재 정답률이 목표 정답률 0.5에서 얼마나 벗어났는지를 나타내는 거리 척도.
해석: 정답률이 0.5에 가까울 수록 거리가 작아져 가중치가 1에 가까워지고, 0이나 1에 가까울수록 거리가 커져 가중치가 0에 가까워짐. 모델의 현재 능력에 간신히 붙어있는 있는 문제일수록 더 집중적으로 학습함.
$A_i$는 같은 문제에서 여러 응답들의 보상 평균과 비교한 i번째 상대적 어드벤티지를 의미함. w(q)는 위에서 정의하였음. $\rho_{i,t}$는 현재 정책과 이전 정책 사이의 토큰 수준 확률 비율임 (GRPO와 같네)
$\varepsilon$는 클립핑 계수 - RL버전 Learning rate
고려 사항:
Ref모델로 훈련전 모델 사용함. vLLM, KV cache,등을 사용하면, 이론적으로는 같은 산출물이 되어야하지만, 다른 값이 나옴.
[문제가 되는 상황 - 오프폴리시처럼 동작] 1. 롤아웃 엔진으로 데이터 잔뜩 생성해둠 (모델 버전 A) 2. 모델이 여러 번 업데이트되어 버전 B, C, D가 됨 3. 그런데도 여전히 버전 A가 만든 오래된 롤아웃 데이터로 학습 계속함 → 모델이 이미 변했는데 옛날 데이터 기준으로 학습 → 불일치 누적, 불안정
[해결책 - 온폴리시 강제] 1. 롤아웃 생성 (모델 버전 A) 2. 그 데이터로 즉시 1번만 업데이트 (버전 A → B) 3. 다시 새 롤아웃 생성 (모델 버전 B, 최신 상태로) 4. 그 데이터로 즉시 업데이트 (버전 B → C) ... 매번 최신 모델로 롤아웃을 새로 생성하고 바로 학습 → 데이터와 학습 모델 사이의 시차를 최소화 → 확률 불일치 누적을 막음
2.2.2 Multi-domain Reasoning RL
수학, 코드, STEM등 같은 MGPO를 사용하나 검증은 다르다. 수학은 최종 답에 의존, 코드는 Test 케이스에 의존, STEM과제는 답 매칭과 선택지 검증을 결합함.
2.2.2.1 Training Data
모든 데이터는 감독 신호를 갖춘 데이터로 구성, 엄격하게 데이터 오염을 제거함. baseline모델로 롤아웃시 0, 1인 샘플은 제거함.
2.2.2.2. Single Long-context Learning
RL전략에서 점진적으로 컨텍스트 윈도우 확장을 하는게 훈련 비용도 낮추고, 더 나은 추론 성능을 이끌어냄.
선행 연구: Deepscaler. vibe1.5B
허나 여기서는 작동하지 않음 - 컨텍스트를 짧게 잘라 훈련하면 모델의 Long reasoning역량이 악화되고, 모델이 불완전하거나 과도하게 짧은 추론 경로 쪽으로 편항되는것을 발견함. 이번의 3B모델은 과거의 1.5B모델보다 더 엄격한 초기 데이터 큐레이션이 있었고 SFT도 했기 때문에, 이미 워밍업이 잘 되어있음. 그래서 초기 truncation 워밍업이 모델입장에서는 감옥이 될 수 있음. 따라서 여기서는 64K 긴 윈도우로 RL을 훈련함.
2.2.2.3 Training Strategy
그림 3, 순차적 추론 RL을 채택함. 먼저 수학 RL로 시작하여, 모델의 long-horizon, 복잡한 조건, 다단계 탐색 능력을 강화.
이어서 코드 RL로 넘어가 실행 가능한 논리의 엄밀성, 경계 조건 처리, 프로그램 제약 능력을 향상
정답 경로 집합의 보상은 0이라서, 재분배 전후로 정답 집합 전체의 평균 보상은 변하지 않고, 틀린 답의 보상도 변하지 않아서, 전체 프롬프트 그룹의 평균 보상 역시 보존된다. 따라서 이렇게 훈련해도 편향이 들어가지 않고, 정답에서 상대적 신호를 주어 간결한 추론 경로로 유도한다.
2.3 Offline Self-Distillation
2.2에서 수학 --> 코드 --> STEM순으로 학습을 진행함. 이렇게하면 맨처음 학습한 능력이 catastrophic forgetting이 발생할 수 있음. 따라서,
점수가 높을수록 증류대상이 되는 student모델이 정답 경로를 예측하기 어려워 하는지 계산하는 것. 즉 학습 가치가 높다. (교사는 맞췄지만 학생은 못맞춘 데이터셋임)
점수를 기준으로 솎아냄.
도메인별 길이 구간(bucket)으로 나눠서 그 안에서 점수 순위를 매긴다. (길이 편차로 인한 점수 왜곡을 방지함)
극단적으로 짧은 경로는 제외함 (노이즈에 점수가 휘둘리기 쉬움
점수가 극단적으로 높은 이상치도 제외 (포멧 오류, 노이즈 가능성)
중상위 점수 범위의 경로들을 우선 선택함
선택된 데이터를을 도메인간에 섞음.
통합 데이터셋으로 SFT 수행.
2.4 Instruct RL
마지막으로 instruct RL을 수행. 보다 신뢰할 수 있는 사용자가 사용할 모델로 튜닝함.
형식에 민감한 프롬프트, 긴문맥 지시, 정렬 예제를 포함한 instruction 데이터셋으로 훈련
명시적인 제약이 있는 샘플에 대해서는, 형식, 순서, 항목 수, 키워드 제약, 과제 완수 여부를 검사하는 rubric 기반 verifier로 보상계산
개방형 프롬프트에 대해서는 유용성, 일관성, 지시 준수, 중복성을 평가하는 루브릭 기반 보상 모델을 활용
3. Evaluation
Benchmarks: AIME25,26 // HMMT25, BruMo25, ...
Evaluation protocol
vLLM을 추론 백엔드로 사용, 별도 이야기가 없으면 temperature 1.0, top-p=0.95, top-k=-1 적용, 출력길이 제한 없음.
검증:
수학: 수식 검증기 + LLM as judge함께 사용
코드: 생성된 솔루션을 실제 테스트에 대해 실행시켜 정답 여부 판정
반복 샘플링 횟수 결정
수학: 64회 독립 생성의 평균 Pass@1
지식 벤치마크: 16회 독립 생성의 평균 성능
코딩 벤치마크: 8회 독립 생성의 평균 성능
CLR을 통한 테스트 시점 스케일링 적용
LeetCode실전 대회 평가
CLR의 필요성 (Test time compute).
기존의 테스트 시점 스케일링(test-time scaling) 기법들, 예를 들어 단순 다수결(majority voting) 같은 방식은 **전체 추론 궤적(trajectory)**을 통째로 비교 --> 정답이 다수결인지만 비교 // 최종 결과만 중요시함. // 문제점: 중간 단계가 틀렸는데도 결함을 못잡아냄.
CLR은 이 문제를 해결하기 위해, 궤적 안의 주장들이 하나하나 맞았나 확인함.
K=32 개의 후보 궤적 생성.
32개를 생성하는 이유는 우연히 맞았는지 틀렸는지 판단하기 위함. 어떤 답이 더 신뢰할 만한가 판단하기 위한 근거.
각 궤적에서 최종 답안 + 클레임 M=5개 추출 (아마도 같은 모델로 클레임 추출하라 할듯)
풀이 과정에서 핵심적인 판단 근거가 되는 중간 주장/명제. decision-relevant을 수집함.
M=5: 한 궤적에서 추출하는 클레임의 개수
각 클레임을 자가 검증 (binary)
같은 모델이 생성자 역할이 아니라 검증자 역할로 자신이 만든 클레임이 맞는지 확인
v(k,m): k번째 궤적의 M 번째 클레임에 대한 이진 검증
판정값을 비선형 변환하여 신뢰도 점수 산출
k: 32개 궤적중 몇번째 궤적인지
m: 해당 궤적에서 추출된 5개 클레임중 몇번째 클레임인지
v(k,m): k번째 궤적의 m번째 클레임에 대한 이진 판정
m: 한 궤적당 클레임 개수
r(k): k번째 궤적 전체의 신뢰도 점수
텀을 나눠서 보면 $\frac{1}{M}\sum v_{k,m}$은 하나의 궤적에서 핵심 클레임들의 평균적인 alignment를 측정함.
다섯개 클래임 모두 맞으면 1, 4개 참이면 0.8임.
근데 여기서 M승을 왜하냐면, 5개 중에 4개 맞으면 0.8점인데, 5개 중 5개 다 맞는것과 차이가 별로 크지 않음.
근데 여기서 5승을 해버리면 0.8 --> 0.33점이 되어버려 급격하게 떨어짐. 거의 다 맞았으니 봐줄게가 아니라, 하나라도 논리적 결함이 있으면 그 궤적 전체를 불신하게 만들어버림.
그래서 k번째 rollout의 최종 신뢰는 $r_k$ 들의 합임.
32개의 궤적중에서 가장 좋은 궤적을 선택하고 Pass@1의 수치가 됨.
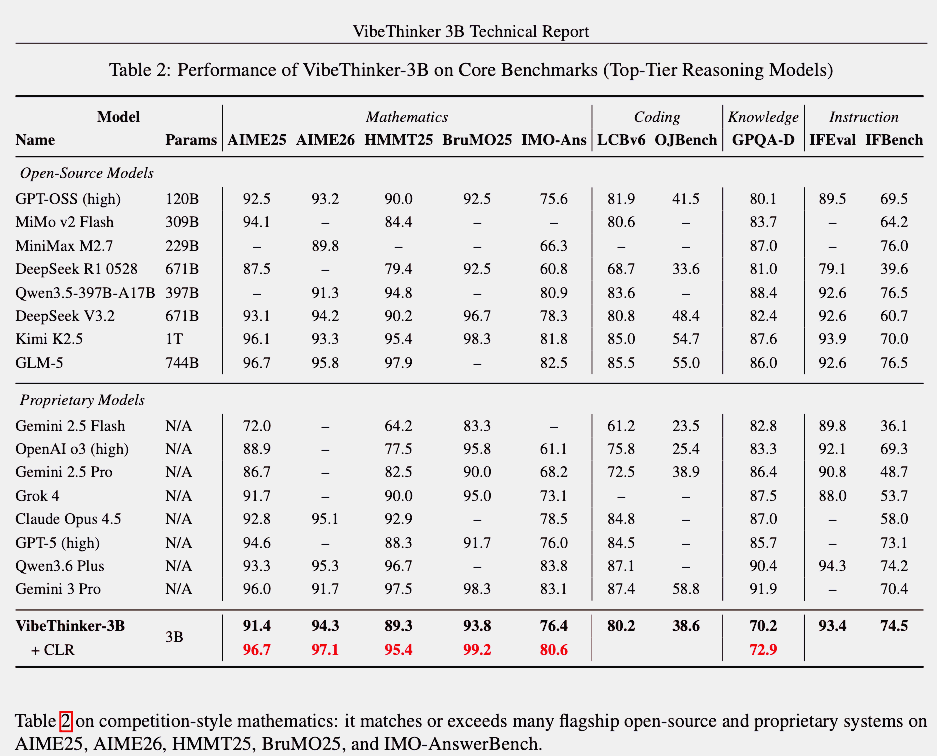
이게 Table2에서 CLR로 표기된 점수임.
근데!!!! 왜 이렇게 좋은게 있다면 왜 Data Curation할때에는 안했을까? Data Curation이 매우 중요하다면서,,??
3.2 Evaluation Results
3.2.1 Overview
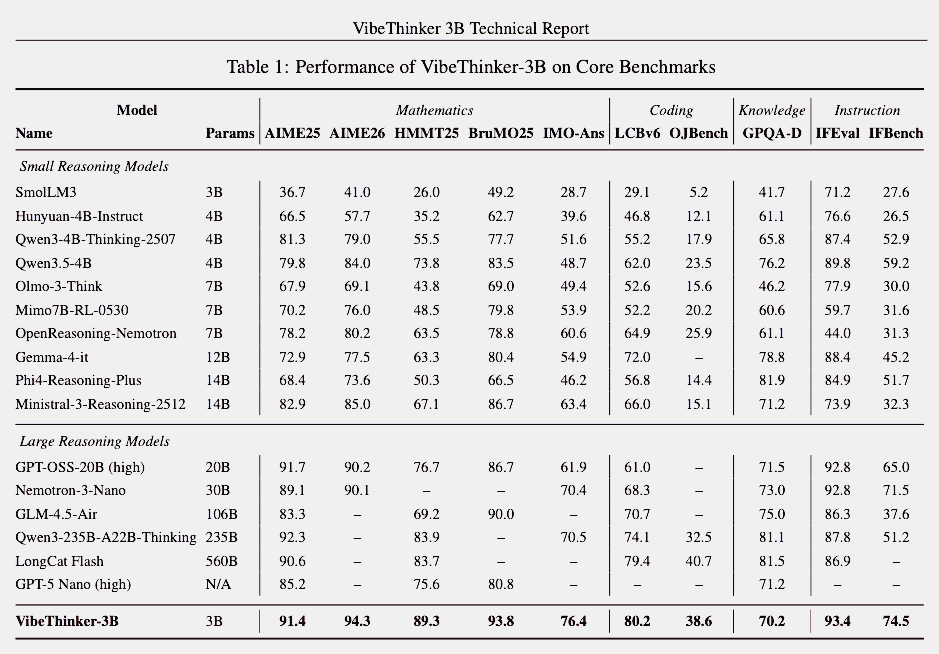
이전 연구(VibeThinker-1.5B): 작은 모델도 얕고 불안정한 추론이 아니라, 추론 과제를 실제로 잘 수행할 수 있음을 입증
이번 연구의 질문 전환: "작은 모델이 추론을 할 수 있는가?" 에서 "최고 추론 시스템 수준에 진입하려면 얼마만큼의 파라미터가 필요한가?"
실험 설계: 1.5B → 3B로 규모를 키우되, 다양성 중심의 포스트 트레이닝 패러다임은 그대로 유지
시사점: 소형 모델의 추론 능력은 파라미터 규모에 선형적으로 종속되지 않으며, 3B 모델은 "크기 대비 우수함"을 넘어 진정한 최고 경쟁력에 도달 가능
3.2.2 Corebenchmark performance
GPQA-Diamond(지식 집약형 벤치마크)에서는 대형 모델과의 격차가 뚜렷
해석: 추론 능력과 지식 저장 능력은 부분적으로만 연관됨. 소형 모델은 구조화된 검증 가능 과제엔 강하지만, 광범위한 지식 회상에는 여전히 용량 한계 존재
3.2.3 Comparison with top-tier reasoning models.
Test Time Compute (CLR)적용 후 추가 도약함.
3B가 일반 목적 종합 역량(백과사전적 지식, 개방형 지시 따르기)에서 선두를 따라잡았다는 뜻은 아님
핵심 의의: "검증 가능한 추론 과제"에서는 일류 성능이 더 이상초대형 모델의 전유물이 아님
CLR 적용 후 플래그십 모델들과 대등 혹은 능가 (근데 플래그쉽 모델들도 이거 적용해 볼 수 있는 것 아님?)
LLM들 사이에서 조율 전략을 자동으로 발견하도록 훈련됨. -- 효과적인 에이전트 간 협력을 위한 커뮤니케이션 토폴로지를 설계, 각 LLM의 역량을 최대한 활용할 수 있도록 프롬프트 엔지니어링하는 방법까지 학습.
LiveCodeBench, GPQA -- SoTA
1. Introduction
LLM은 최근 높은 성능을 달성함
그러나 잠재력을 최대한 활용하는 것은 어렵다
수작업으로 만든 에이전틱 워크플로는 상용 AI 제품의 핵심, 효과적인 프롬프팅과 자기 개선 전략은 연구의 핵심 주제로 다뤄지고 있다. 서로 다른 모델들은 각기 특정 데이터셋과 도메인에서 전문성을 갖추도록 파인튜닝되어 있어, 모든 태스크에서 최고인 언어 모델은 존재하지 않는다.
따라서 RL Conductor를 연구.
강화학습으로 훈련된 새로운 형태의 추론 모델로, 복잡한 문제를 동적으로 분할하고, 타겟화된 서브태스크를 위임하며, 워커 LLM 에이전트 pool을 위한 커뮤니케이션 토폴로지를 설계함.
일련의 워크플로 스텝들을 출력하도록 설계. 각 스텝은 자연어 지시문 (전체 태스크의 특정 측면에 집중하는), 식별자 (해당 지시문을 수행할 에이전트), 그리고 각 에이전트가 자신의 역할을 수행하는 동안 다른 에이전트의 결과물에 어디까지 접근할 수 있는지를 담고 있다.
Conductor는 입력에 맞춤화된 완전히 유연한 에이전틱 워크플로를 구성할 수 있으며, -- 프롬프트 엔지니어링, 정제, 심지어 메타 프롬프트 최적화와 같은 일반적인 전략들이 엔드투엔드 보상 최대화를 통해 자연스럽게 훈련됨.
사전 훈련된 Conductor에 두 가지 방법을 파인튜닝해 프레임워크를 확장(테스트 타임 compute 투여)
각 스텝에서 무작위로 샘플링된 에이전트 풀로 훈련 --> 모델이 임의의 오픈소스 및 클로즈드소스 워커 집합으로 일반화될 수 있음을 확인. 이를 통해 API 호출 없이도 최고 수준의 성능을 달성할 수 있음.
둘째, Conductor가 스스로를 워커 LLM으로 지정할 수 있도록 허용함 -- 새로운 형태의 재귀적 협력이 생겨나며, 이는 추론 모델에서 조정 가능한 inference time scaling을 열어준다
2. Reinforcement learning and reasoning
강화학습을 통해서 Test time compute이 발전되었음.
핵심 레시피: DeepSeek R1 계열 연구에서 처음 제안 -- 커스텀 시스템 프롬프트를 활용해 LLM $\pi_{\theta}$ 를 최적화. 구체적으로 검증 가능한 문제세트 D = ($q_1, s_1$), ..., ($q_N, s_N$)에 대해 모델이 스스로 (completion) $o_i$를 생성하도록 함. 커스텀 시스템 프롬프트는 사고 과정(thinking trace)을 먼저 제시하도록 지시하며, 각각을 <think>와 <solution> 태그 안에 담도록 함.
형식 조건: 모델의 출력이 지정된 <think>/<solution> 형식을 따르지 않을 경우 $r_i$를 −1로 설정
정확성 조건: 형식을 올바르게 지킨 출력이 정답 $s_i$와 일치하면 $r_i$를 1로, 그렇지 않으면 -0.5로 설정
이 보상을 기준으로 GRPO함.
GRPO는 각 데이터셋마다 LLM $\pi_{\theta}$로 하여 {$o_1, o_2, ..., o_G$}를 생성하도록 함.
이때 KL-div 페널티가 있음. 식은 아래와 같음.
3. Learning to conduct and orchestra of models
새로운 강화학습 프레임워크를 설계. Conductor는 훨씬 큰LLM 에이전트들을 대상으로 프롬프트 엔지니어링과 조율을 수행함.
입력 태스크를 분할, 자연어로 된 서브태스크를 할당, 에이전트들의 상호 보완적인 능력을 최대한 활용하기 위한 커뮤니케이션 전략을 정의하는 완전한 에이전틱 워크플로를 출력.
3.1 FRAMING AGENT COORDINATION IN NATURAL LANGUAGE
Conductor의 목표: 입력 질문 $q_i$에 특화된 에이전틱 워크플로를 설계 --> 태스크를 간접적으로 해결하는 것
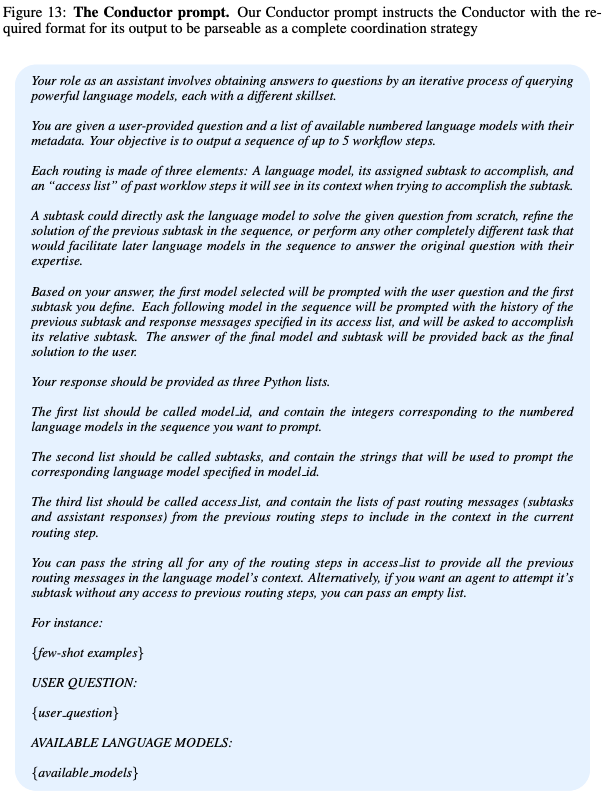
정의. 각 에이전틱 워크플로우 -- 워크플로 스텝들의 나열로 정의, 최종 출력이 실제 Conductor 응답 $o_i$로 반환된다. 각 스텝은 아래와 같은 정보를 담고 있다. Figure2예시 있음.
서브태스크 문자열 — 이 모델에게 뭘 시킬지
워커 에이전트 ID — 누가 할지
접근 목록(access list) — 이 모델이 작업할 때 이전 스텝의 결과를 볼 수 있는지 -- 여기서는 [all], [] 두가지가 있음. []는 과거 결과중에 아무것도 볼 수 없고 모델 스스로 생각해야함.
Figure 2 예시)
Conductor는 먼저 에이전트 2에게 알고리즘을 설계하도록 질의하고, 이어서 에이전트 0에게 에이전트 2의 이전 답변을 컨텍스트로 제공한 상태에서 파이썬으로 구현하도록 하는 에이전틱 워크플로를 생성
Prompt: figure 13, appendix E. 학습을 원활히 하기 위해 시스템 프롬프트로 상세한 지침, 기대되는 출력의 예시를 제공함. 이 설계를 통해 워커들에게 서브태스크와 커뮤니케이션을 자유롭게 구성할 수 있으며, 다양한 에이전틱 워크플로를 구성할 수 있다.
워크플로 실행과 학습 역학. Conductor가 출력한 각 에이전틱 워크플로 --> 지정된 워커 에이전트들에게 자연어 서브태스크를 프롬프트로 실행. 여기서는 conductor가 딱 한번 실행됨.
Figure2를 보면 더 이해하기 쉬운데, model 2,0 순차적으로 실행이 되고, 각각의 서브테스크도 순차적으로 나열되어 있고, 볼 수 있는 정보 권한도 나열되어 있음. 여기서는 model2는 앞의 정보를 보지 못하지만, model0은 앞에서 출력된 정보를 다 볼 수 있음.
[user] : 유저 원본 질문 + "Develop an efficient algorithm..."
스탭 2 (Model 0, access_list = ["all"]):
[user] : "Develop an efficient algorithm..." ← 스텝1 서브태스크 [assistant] : "...알고리즘 설계 결과..." ← 스텝1 Model 2의 답변 [user] : "Implement the algorithm..." ← 스텝2 서브태스크
전통적인 RL 프레임워크와 유사하게, Conductor 모델의 각 응답에 대한 보상 $r_i$는 두 가지 조건에 의해 결정:
Conductor 포맷 조건: 서브태스크, 워커 ID, 접근 목록의 파이썬 리스트를 파싱할 수 없는 응답의 경우 $r_i$를 0으로 설정
Conductor 정확도 조건: 올바르게 포맷된 에이전틱 워크플로를 실행한 최종 출력 $o_i$가 솔루션 $s_i$와 일치하면 $r_i$를 1로, 그렇지 않으면 0.5로 설정
Conductor는 임의의 RL 알고리즘으로 학습되지만, 이 연구에서는 GRPO를 사용함. 이 단순한 방법으로 Conductor를 훈련하면, 각 워커의 강점과 부합하는 문제 분해 방식과 프롬프트 엔지니어링된 서브태스크가 생성되고, 독립적인 시도와 최종 토론 라운드를 결합한 커뮤니케이션 전략도 함께 발생한다
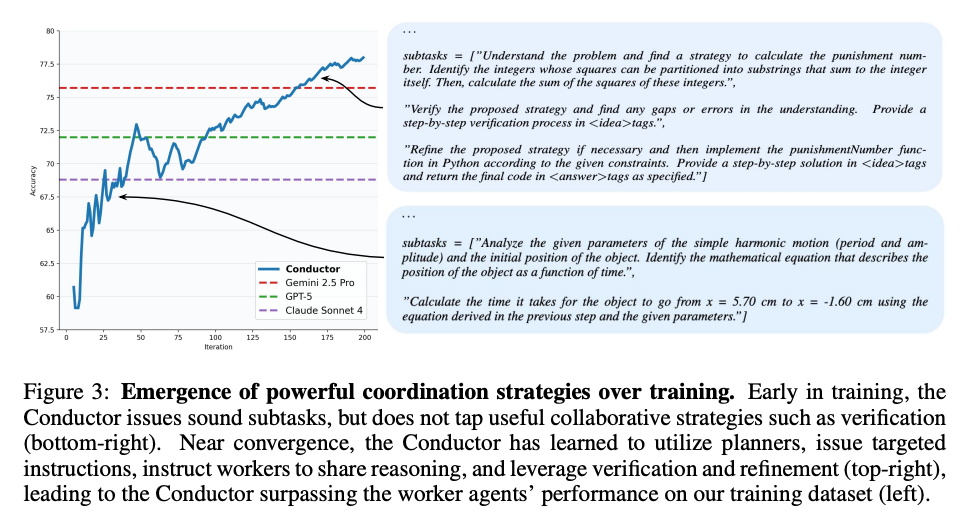
그림 3과 이하 절 - 수작업으로 설계된 멀티에이전트 파이프라인을 뛰어넘는 최첨단 성능을 달성
3.2 Extending the RL Conductor
Adaptive worker selection. Conductor는 7개의 모델에서 훈련됨. 그러나 일부 모델만 차용해서 Conductor를 사용하고 싶다면?
훈련 완료된 Conductor가 있음.
파인튜닝: 매 질문마다 7개 중 랜덤하게 k개 모델만 골라서 진행
질문1: GPT-5, Gemini, Claude
질문2: DeepSeek, Qwen, Gemma
...
Conductor가 학습하는 것: 어떤 모델 조합이 주어지든, 그 조합 안에서 최선의 워크플로 짜는 법을 배움.
논문에 의하면 오픈소스 모델만 줬을 때도 단일턴 Claude Sonnet 4단독보다 10% 높은 성능 달성. (table 7)
Recursive topologies and test-time scaling.
문제: Conductor가 처음에 워크플로 한번 만들고 끝남 --> 중간에 결과과 별로여도 워크플로 수정이 불가.
이를 해결하기 위해 conductor가 자기 자신을 워커로 호출할 수 있게 확장함.
파인튜닝 전: Conductor로 훈련
파인튜닝: 훈련 절반은 기존의 방식대로 훈련, 나머지 절반은 재귀 호출을 강제로 1번 추가해서 학습함.
의문: 학습할 떄 한번의 재귀호출으로만 훈련을 하였는데, 과연 실제 문제에서 여러번의 재귀호출이 가능할까?
무한한 재귀 루프를 방지하기 위해, 재귀 호출이 지정된 최대 횟수까지만 허용되도록 함.
4. Evaluating the RL conductor
4.1 Training and evaluation setup
Conductor: Qwen2.5-7B 소형 Conductor를 학습.
워커: Gemini-2.5-Pro, Claude-Sonnet-4, GPT-5, DeepSeek-R1-Distill-Qwen-32B, Gemma3-27B-instruct, Qwen3-32B --> 최대 다섯 단계의 에이전트 워크플로를 설계하는 임무 수행.
학습 데이터셋: 수학, 코딩, 일반 실세계 추론 등 네 가지 추론 영역에서 선별한 960개의 문제, 문제의 난이도와 다양성을 중심으로 선정. (MATH, MMLU, RLPR, LiveCodeBench V1).
추가 설명:
(강점) 강력한 워커로 인하여 RL로 학습된 소형 모델들이 흔히 겪는 탐색 문제를 효과적으로 우회 --> 작은 모델로 sampling을 여러번해도 모든 reward가 0으로 나옴 --> 파라미터 업데이트가 없음.
4.2 Elevating LLMs to a new frontier with the conductor
표 1에서 확인되듯, Conductor는 도메인 내외 평가 모두에서 각 태스크의 기존 최고 기준선을 상회하며 최고 기록을 경신
AIME25와 GPQA-Diamond에서 기존 최고 대비 약 3%포인트 향상 --> 모델간의 세대가 바뀌는 수준임 (o3 --> GPT5)
다양한 분야에서 동시에 성능 달성
4.3 Controled Large-scale evaluation
self reflection 베이스라인:
각 에이전트가 동일한 문제에 대해 최대 5회 반복 시도
매 시도마다 이전 답변을 모두 컨텍스트에 유지하며 스스로 수정, 개선
멀티에이전트 라우팅 기준선 (4종)
MASRouter: 사람이 설계한 고정 조율 전략(4~5개 모델·역할 조합)에서 선택
MoA: 전체 모델이 독립적으로 답변 후 집계 모델이 통합 (총 8회 모델 호출)
RouterDC: 질문을 분석해 단일 최적 모델로 라우팅
Smoothie: 테스트 타임에 모델 출력을 기반으로 최적 모델 선택
기존 한계:
기존 방법들은 모두 미리 정해진 선택지 중에서 고르는 라우터 분류기 방식
조율 전략을 자연어로 자유롭게 표현하지 못하므로 표현력이 본질적으로 제한됨
Conductor는 자연어를 출력 매체로 직접 사용 → 완전한 명세 자유도 확보
결과1:
그림 4에서 확인되듯, 모든 태스크에서 자기반성과 멀티에이전트 기준선 전체를 상회
비제약적 프롬프트 엔지니어링과 태스크 위임 능력이 기존 고정 전략이 넘지 못하는 결정적 차이를 만들어냄
결과2:
Conductor는 정규화 없이 학습, 평균 3스텝 워크플로만으로 수렴함.
RouterDC를 제외한 기준선이 COnductor보다 많은 API호출 사용
결과3:
MASRouter는 인간 설계인데, 최적의 조합 찾기가 인간이 더 못함.
설계된 도메인 밖에서 일반화 제한됨.
4.4 User-Customization and test-time recursive scaling
동적 워커 풀 (파인튜닝으로 모델 선택 유연화)
항상 전체 7개 모델에 접근 가능한 상태로 학습 → 오픈소스 모델을 거의 활용하지 않음
사전 학습된 Conductor를 매 스텝마다 무작위 k개 모델 부분집합으로 파인튜닝
오픈소스 모델만 쓸 경우에도 Claude Sonnet 4를 ~10%p 앞섬, 클로즈드소스만 쓸 경우 기존 성능 그대로 유지
사용자의 비용·요구사항에 따라 모델 구성을 바꿔도 강한 성능 유지 가능
Conductor가 자기 자신을 워커로 호출
기존 Conductor는 한 번 워크플로를 짜면 끝 → 결과가 나쁘더라도 수정 불가
파인튜닝 시 절반의 샘플에 재귀 호출을 수동으로 삽입해 학습
추론 시점에 최대 재귀 횟수를 조절하는 것만으로 새로운 테스트 타임 스케일링 축 확보
4.5 Analyzing and ablating the properties of an effective conductor
Conductor 모델 사이즈: 작으면 지시문 만드는 역량이 떨어져서 큰 모델보다 성능이 낮아짐.
테스크 난이도: 어려울 수록 Conductor를 Self hosting하는 현상이 많아짐.
훈련 디테일:
GRPO식에서, reference 모델 사용안함, KL div 페널티도 0으로 설정함:
distribution이 안깨지게 막아주는 두개의 safe를 꺼버림. 이렇게 해도 되는 이유가, 7B 모델의 성능보다, 워커 LLM의 힘을 빌리는 구조임. 기존에는 혼자 다 풀어야하는 구조와 다르게, 워크플로우만 잘 만들면됨. 그리고 형식이 무너지면 R=0으로 페널티가 알아서 걸림.
다양한 모델들을 결합하는 것 --> 유망한 접근법이긴 하나 weight-merging은 아키텍처 불일치, 폐쇄형 API라는 어려움이 있음.
TRINITY는 이 문제를 light-weight coordinator로 해결. 이 코디네이터는 LLM들 간의 협업을 조율, 소형 언어 모델(약 0.6B)과 경량 헤드(약 10K 파라미터)로 구성되어 -- 효율적이며, 진화 방법으로 최적화됨.
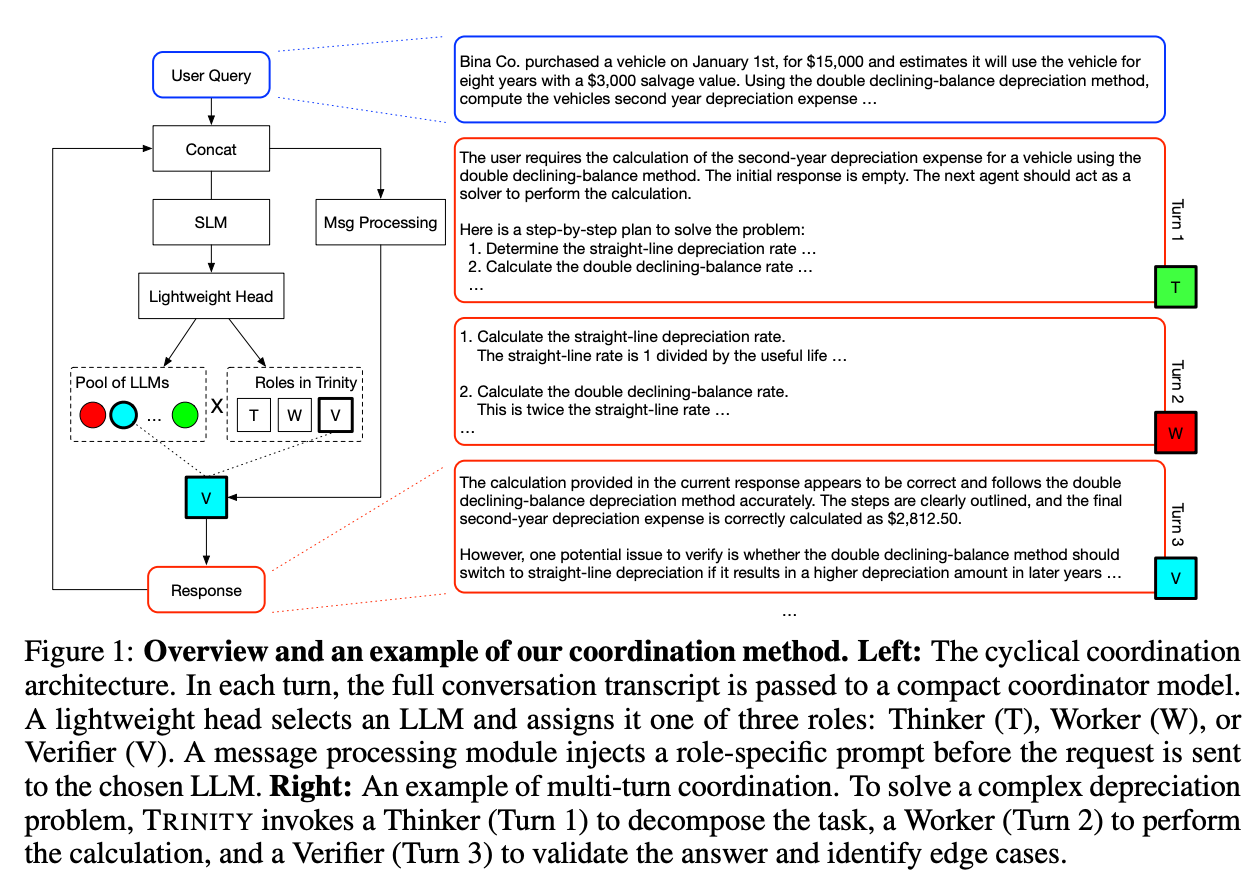
TRINITY는 여러 턴에 걸쳐 쿼리를 처리하며, 매 턴마다 코디네이터가 선택한 LLM에 세 가지 역할 중 하나—Thinker, Worker, Verifier—를 부여. 이를 통해 복잡한 기술 습득의 부담을 코디네이터 자신이 아닌 외부 LLM들에게 효과적으로 위임
광범위한 실험을 통해 TRINITY가 코딩, 수학, 추론, 도메인 지식 등 다양한 태스크에서 개별 모델들과 기존 방법들을 일관되게 능가하며, 분포 외(out-of-distribution) 태스크에서도 강건한 일반화 성능을 보임을 입증.
1. Introduction
LLM은 스케일을 키우는 방향으로 발전함. 그러나 이건 자원 집약적임.
대안으로는 model merging - 여러 모델의 파라미터를 통합하는 방식이나 아키텍처 간 비호환성 및 대부분이 비공개라 적용 어려움
이 논문의 대안: 추론 시점에서의 모델 합성, 즉 조율(coordination)을 통한 방식을 제안. 이는 개별 모델의 가중치를 수정하지 않고도 다양한 모델들이 가진 상호보완적인 강점을 결합한다. 이 방식은 모델을 재학습하지 않고도 성능 향상을 이끌어낼 수 있다.
코디네이터의 핵심 과제: 주어진 쿼리를 효과적으로 파악하기 위한 맥락 이해 능력을 갖추는 것 이다. 저자들은 이 신호를 SLM hidden states로부터 효율적으로 추출될 수 있다고 생각했음. 출력 시퀀스에서는 마지막에서 두 번째 토큰의 은닉 상태가 풍부한 맥락을 담고 있다. 이 토큰은 전체 시퀀스에 걸쳐 어텐션을 수행하고 특수 토큰(<\think> 또는 EOS 토큰 등)의 예측을 이끌어 안정적인 출력 분포를 보장하기 때문이다.
가설: SLM의 맥락적 표현이 LLM을 효과적으로 조율하기에 충분한 의미론적 신호를 담고 있다.
TRINITY는 SLM(0.6B 파라미터)과 경량 헤드를 활용해 여러 LLM을 multi-tern tuning하며, 학습 가능한 파라미터의 총 수는 20K 미만.
매 턴마다 TRINITY - LLM을 선택, 원본 쿼리에 이전 턴의 전체 대화 기록을 이어붙임.
경량 상태를 유지하고 복잡한 기술 습득을 외부에 위임
Thinker: 고수준 전략과 문제 분해를 담당
Worker: 구체적인 문제 해결 단계를 수행
Verifier: 현재 풀이의 타당성과 완성도를 평가. 검증자가 선택되어 현재 답변을 최종 답으로 수락하거나, 정해진 턴 예산이 소진되면 프로세스가 종료
Representation-to-coordination mapping의 최적화는 어렵다.
강화학습의 단점: coordinator의 파라미터가 10,240이라고 가정
SNR (Signal to Noise Ratio) = 신호(작음) / 노이즈(큼) --> 거의 0에 수렴. (논문 뒤에서 강화학습으로 훈련해봤는데 효과 없음을 보이는 실험이 있음.)
Weak Coupling: 파라미터 하나가 최종 보상에 미치는 영향이 1/10,240 수준 --> 신호가 너무 약함.
Binary Reward: 같은 파라미터로 실행할 때마다 보상이 달라짐. 조금 잘했는지 조금 못했는지에 대한 신호가 없음, 그리고 맨마지막 답변에 좌지우지됨
Bernoulli call: E2E 실행을 atomic evaluation혹은 베르누이 콜이라고 한다. 보상이 베르누이 분포를 따르기 때문임.
한계: SLM의 Context Length를 32K로 제한해두었음. 그리고 이 상황에서 최적화를 하여 비용이 얼마 안들어갔음.
3. TRINITY
목표: sep-CMA-ES로 최적화된 코디네터 학습, 외부 LLM풀을 오케스트레이션, 멀티턴 추론에서 서로 다른 역할을 부여하는 방법 학습
3.1 Efficient Parameterization
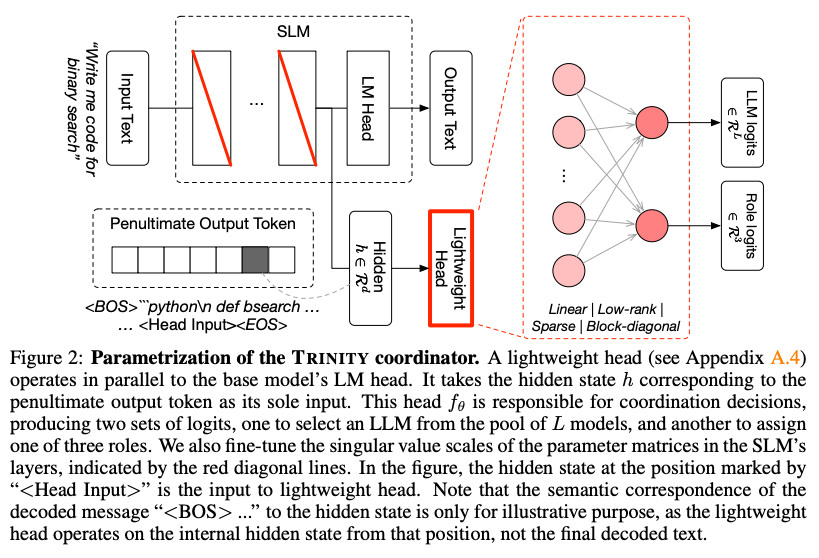
표현 공간과 조율 공간을 효율적으로 도출하기 위해, coordinator는 Figure 2에 나타난 것처럼 효율적인 파라미터화 방식을 채택
사전 학습된 SLM을 백본으로 사용, 두 가지 학습 가능한 파라미터를 도입함.
첫째, 코디네이터 SLM의 마지막 은닉 레이어 바로 뒤에 경량 헤드를 추가한다. 여기서 LM Head는 nn.Layer(d, vocab)임
L개의 에이전트를 조율하기 위해, d --> agent수로 맵핑 필요. 또한 역할 배정을 위한 d --> 3개 가 필요. 정리하면, d --> (n+3) 맵핑하는것이 필요함.
이게 Lightweight Head이고, nn.Layer(d, n+3)으로 생각해 볼 수 있음.
둘째, 효율적 파인튜닝에 관한 최근 연구 (Sun et al., 2025)에서 영감을 받아, 특이값 파인튜닝(singular value fine-tuning) 방식으로 백본 레이어의 일부를 튜닝함. 여기서 일부라는것은 select the second-to-last layer of the 0.6B model for singular value fine-tuning(section4.1)
SVF: SVD에서 확장.
구체적으로, 코디네이터 SLM의 선택된 가중치 행렬들에 대해 특이값 분해(SVD)를 수행하고, 직교 행렬은 고정한 채 특이값 $\sum$ 스케일만을 학습한다. 이 파라미터화 방식은 학습 가능한 총 파라미터 수를 20K 미만으로 유지하여, 일반적인 파인튜닝 방식보다 수 자릿수 작게 만들면서도 표현력의 이점을 유지한다
W         =    U      ×    Σ       ×   V^T
(3×3)        (3×3)       (3×3)       (3×3)

[3 1 1]    [-0.38 ...]   [6.16  0    0  ]   [-0.57 ...]
[2 4 2]  = [-0.73 ...] × [0    2.23  0  ] × [-0.41 ...]
[1 1 3]    [-0.57 ...]   [0    0    1.00]   [-0.71 ...]
             ↑                ↑                  ↑
           방향 행렬        크기(중요도)         방향 행렬
           (고정)           (이것만 학습!)       (고정)

U와 V^T는 "어떤 방향으로 변환하는가"를 담고, Σ(sigma)는 "얼마나 강하게 변환하는가"를 담음.


# 기존 W를 SVD로 분해
U, sigma, Vt = svd(W)
# U:     고정 (학습 안 함)
# sigma: 이것만 학습!  ← 핵심
# Vt:    고정 (학습 안 함)

# 학습 가능한 스케일 s를 sigma에 곱함
s = nn.Parameter(torch.ones(rank))  # 초기값 1 (아무 변화 없음)

# forward pass
def forward(x):
    sigma_scaled = sigma * s          # 특이값에 스케일 적용
    W_adapted = U @ diag(sigma_scaled) @ Vt
    return W_adapted @ x
좋은점: 코디네이터가 생성한 텍스트는 폐기됨. 따라서 compute efficient함 --> 프롬프팅 역할은 풀 내의 LLM들에게 위임(섹션 3.2).
파라미터 효율성과 빠른 추론 조합 덕분에, 진화 전략으로 TRINITY 전체 시스템을 학습하는 것이 가능해진다 (섹션 3.3).
--> 이는 모방 학습(imitation learning)이나 강화학습(RL)의 막대한 데이터 및 계산 오버헤드를 피할 수 된다.
3.2 Tri-Role coordination
이 섹션: 코디네이터가 활용할 수 있는멀티 에이전트 상호작용 패턴의 집합에 대해 설명
핵심 아이디어: 코디네이터 자체가 에이전트들만큼 능력이 뛰어날 필요가 없다. 좋은 코디네이터는 다양한 LLMd을 활용하고 조율하는 것. (사장은 모든 것에 전문가일 필요가 없고 좋은 직원을 잘 고용하는 것처럼?)
Query에서 최대 K턴에 걸쳐서 진행됨. k-1턴의 대화 기록을 $C_{k-1}$ = ($Q, O_1, ..., O_{k-1}$) 여기서 O들은 {Thinker, Worker, Verifier} 의 결과물 중 하나임. 정확하게 말하면 세개의 agent에서 나온 결과물을 후처리한 결과물임. --> 근데 어떤식으로 후처리를 했는지는 논문에 나오지 않음.
만약에 trajectory가 너무 길어지면, SLM의 input context limit으로 인해 훈련이 안될 가능성이 있기에, 후처리는 요약이든 핵심정보만 남기는 방식을 사용하지 않았을까 싶은데,,
이어서,,... k번째 턴테서 Agent풀인 M에서 코디네이터가 적절한 에이전트(or LLM)을 선택하고 - $A_k$, 역할 $R_k \subseteq$ {Thinker(T), Worker(W), Verifier(V)}를 배정함 (프롬프트 중집함). 이후 코디네이터는 $C_{k-1}$와 역할 준비하고, $A_k$ 에이전트에 쿼리해서 메시지 $M_k$를 얻는다. $M_k$를 후처리하여 $O_k$로 만들고 이를 다음 턴의 대화 기록에 추가한다.
TRINITY에서는 세 가지 역할 Thinker, Worker, Verifier를 정의하며, 각각 다른 prompt 보유
Thinker는 전략을 세운다.Thinker는 현재 상태를 분석, 해결책에 대한 계획, 분해 방법, 또는 비판을 포함하는 메타 수준의 지침을 생성. 하위 목표에 대한 계획을 제안할 수 있고, 코디네이터는 이를 O_k로 압축하여 이후 턴을 이어감. 또한 다음 에이전트의 역할을 계획과 함께 명시할 수도 있음
Worker는 실행한다.Worker는 구체적인 태스크 수행. $C_{k−1}$을 입력받아 실행 가능한 내용(예: 유도 과정, 코드 스니펫, 수치 결과)을 생성. 코디네이터는 핵심 정보를 추출하여 O_k로 저장한다.
Verifier는 검증한다.Verifier는 $C_{k−1}$에 누적된 해결책이 올바른지, 완전한지, 그리고 Q에 대한 응답으로 적절한지를 확인한다. $u_k$ ∈ {ACCEPT, REVISE}와 선택적 진단 $ρ_k$를 출력. 코디네이터는 ($u_k$, $ρ_k$)를 $O_k$로 기록하며, $u_k$ = ACCEPT이면 종료 한다.
3.3 Learning with an evolutionary strategy
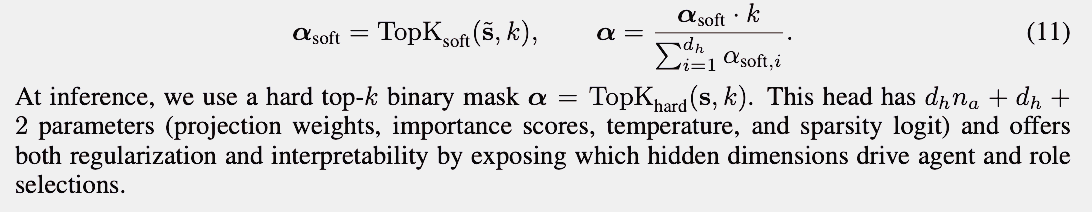
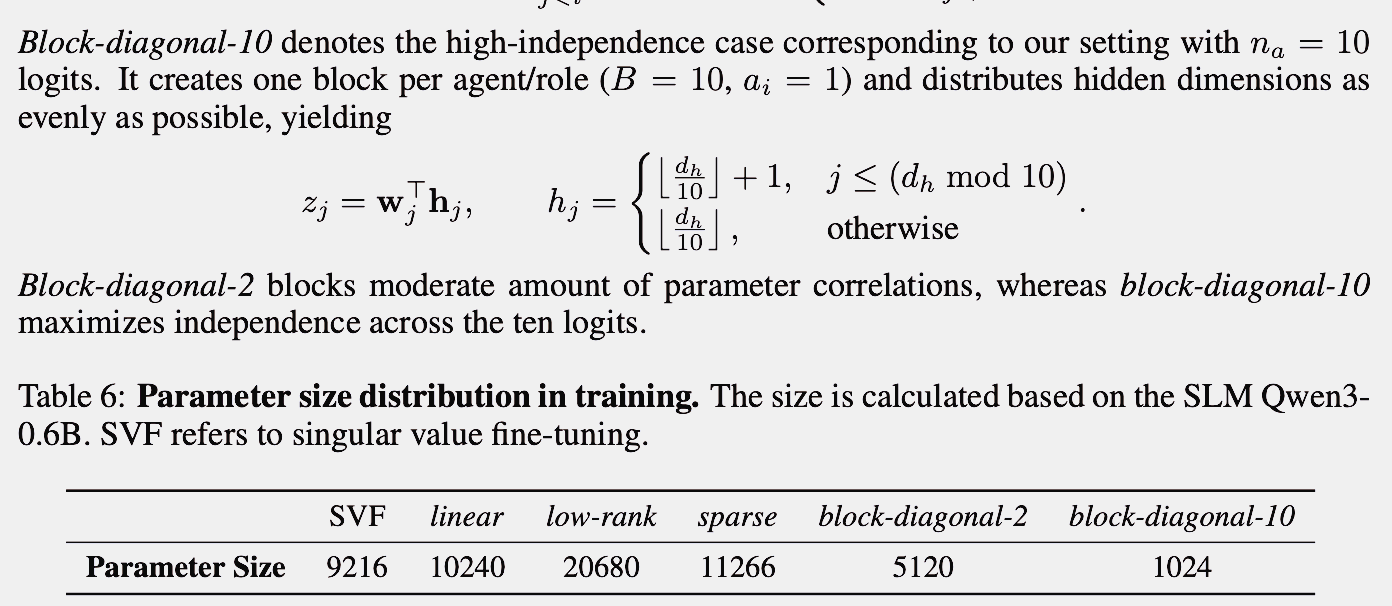
objective function 탐색: 헤드 아키텍처를 다양하게 바꿔보면서 (부록 A.4), block-diagonal-10 헤드가 파라미터 수가 매우 적음에도 불구하고 성능의 상당 부분을 유지한다는 것을 확인 (섹션 4.7).
Appendix.4 Head Architecture Design - Figure2의 Lightweight head 아키텍처 탐색
SLM의 은닉 상태 $h \subseteq$ $R^{d_h}$ --> $z \subseteq R^{n_a}$ (에이전트 및 역할선택 로짓) 로매핑하는 네가지 헤드를설명. 이후소프트맥스 또는argmax를 통해 확률로변환된다.
1. Linear Head (중요 x)
z = Wh, where $W \subseteq R^{n_a * d_h}$ torch에서는 nn.Linear(n_a, d_h, bias=False)
hidden state에서 로짓으로 변환하는것은 아핀 변환(바이어스 없음), 베이스라인 역할을 함. 빠르게 학습되는 장점이 있음
으로 각각 나누고 softmax, argmax하여 llm과 role선택함. (혹은 학습중에는 다양한 확률로 학습하기 위해 argmax대신 sample을 사용할 수도 있음)
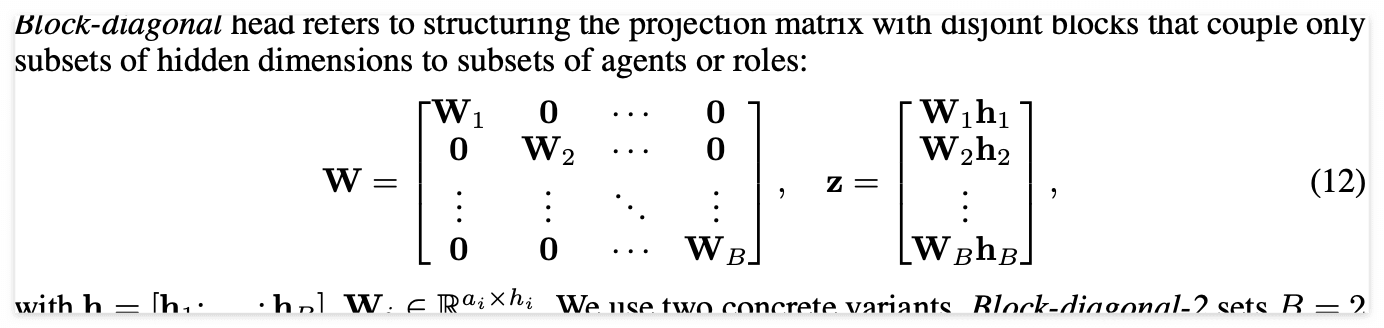
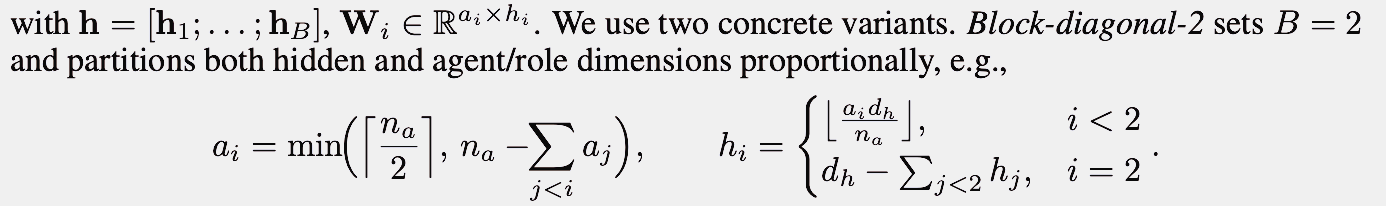
4.2 Block-diagonal-10 (B=10)
4.1의 설명과 상동
파라미터를 보면, block-diagonal-10의 파라미터의 수가 매우 작음을 볼 수 있음.
torch로 구현시 희소 행렬을 다루는 코드가 있었던 것 같은데, 고민이 필요.. torch.sparse_coo_tensor인가 그랬던 것 같음 (collaborative filtering 모델들에서 사용햇었는데,,,.다른 방법이 있을 수도?), 아니면 multi-head attention할때처럼 해도 될것 같음. 차원을 하나 더 늘려서 매트릭스곱을하면 될듯?
block-diagonal-10이 성능 상당부분 유지함 --> 분리 가능성을 보인다는것을 보임. 이 구조는 정보의 대부분이 블록 내부에 집중되어 있으면 블록 간 간섭을 무시할 수 있다, 반대로 이러한 구조는 강화학습을 분리하게 만드는데(4.8참고)
조건이 나쁜 그래디언트: 파라미터가 10,000개인데 보상은 0,1 하나뿐임 따라서 각 weight별 들어가는 신호가 평균적으로 0.0001%임. 미분(reward / w)을 하면 0에 가까운 숫자가 되어버림. --> 신호 대 잡음 비율이 너무 낮음.
Poor credit assignment: Turn1 ~ Turn N이 있는데, 어떤 turn의 역할이 중요 역할을 했는지 알기 어려움 (보상이 마지막에만 나오니까)
근데 왜 그럼 다른 LLM에서는 RL이 성공했을까?
GRPO의 경우는 reward와 token으로 학습됨. 생성된 토큰이 많기 때음. 예 1000개 토큰 생성, 그래디언트 업데이트가 1000번일어남. 만약 무제한의 시간과 예산이 있다면 Trinity에도 강화학습을 해볼수 있고, 성능도 더 좋아질 수 있음. 비용은 천문학적.
이 논문에서 사용한 API비용은 $500~$2000정도로 예상됨. (학습 데이터셋은 약 7,000개, 최대 턴수 5)
이러한 이유로 sep-CMA-ES로 학습함.
여기서 제약사항은
LLM모델들의 파라미터는 수정할 수 없음
0,1 신호로 학습을 해야하는데, 미분이 불가능함.
진화 전략을 택함.
부모의 parameter에서 노이즈를 추가한 자식 32개를 만든다.
각 후보를 평가하여 적합도 점수를 얻음. 16번 시도를 해서 정답률을 구함. 정답률 순서로 내림차순
상위 16개의 자식의 weight을 가중평균하고 이 weight이 새로운 부모가 된다.
sep-CMA-ES에서 작동하고, full-CMA에서는 작동안함 왜냐하면 각 파라미터간의 상관성을 고려하기 때문에 이렇게 임의로 노이즈 추가하면 안됨.
부록 A.1에서 10K 파라미터를 가진 lightweight head, 평가 예산, 이진 보상, 0이 아닌 블록간 결합에 대한 분석을 제공함. 여기서는 요약본을 제공함.
성능
랜덤 탐색(RS)의 성능 향상은 반복을 거듭해도 여전히 로그 수준에 머문다 (Proposition 1과 동일)
sep-CMA-ES는 초반 n번의 보정 기간이 끝나면안정적 수렴 단계에 진입하고, 매 스텝마다 남은 오차를 1/n씩 줄인다 → 즉,기하급수적으로 수렴한다
4. Experiments
멀티 에이전트, 단일 에이전트들과 비교
LiveCodeBench SOTA달성
미학습한 태스크에 성능측정
ablation study: hidden state에 인코딩된 맥락 정보 분석, 진화 기반과 강화학습 분석, 모방학습 랜덤 서치와의 비교
4.1 Experimental Setup
4.1.1 Coordinator and agents
코디네이터 SLM: Qwen3-0.6B를 사용. lightweight head는 10k 파라미터 linear layer를 선택.
0.6B모델의 마지막으로부터 두번째 레이어를 SVF (singular value fine-tuning)으로 선택함.
LiveCodeBench의 경우 V1 release(400개)를 학습에 사용, V6(175개)로 평가.
오픈소스와 클로즈 모델의 일관성을 확보하고 학습을 원활히 하기위해 LLM의 기본 최대 생성 토큰 수를 4,096으로 설정하고, reasoning effort는 최소로 유지함. 최대 협업 턴수는 5로 설정.
네가지 미학습 태스크도 평가 진행 (AIME2025, BigCodeBench, MT-Bench, GPQA-D)
4.1.3 Baseline:
멀티 에이전트 라우팅: MasRouter, RouterDC, Smoothie, MoA, 무작위 에이전트 선택
단일 에이전트:
개별 LLM을 4K, 20K 토큰 한도로 평가함.
단일 에이전트가 5턴에 걸쳐 self reflection을 수행하는 방식
5개 샘플을 만들고 다수결 투표
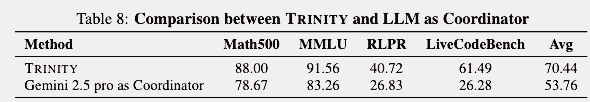
LLM을 코디네이터로 활용하는 모델 (Appendix 7.3)
세부 실험 부록은 Appendix 7.1
LLM 코디네이터로 더 뛰어난 모델로 했다면?
4.2 In-distribution evaluation
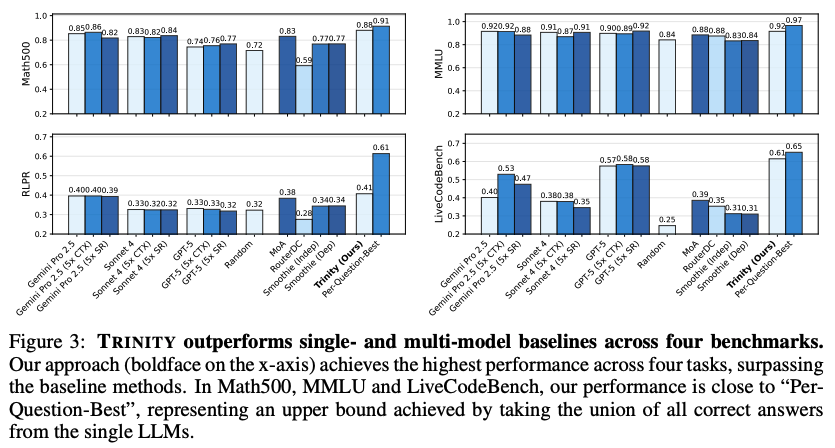
5x CTX는 4K의 다섯배 즉 20K예산한도 / SR은 self-reflection
TRINITY 네가지 벤치마크에서 다른 방법론들보다 우수한 능력 보임.
멀티 에이전트 조합이 어려움: MoA는 Math500, RLPR에서는 좋은 성능을 보이나, LiveCodeBench에서는 약한 성능을 보임. --> 다양한 에이전트를 효과적으로 조율하는것은 매우 어려움. / 반면 TRINITY잘한다고 자랑하고 있음.
RLPR의 RouterDC는 랜덤 LLM 선택보다 점수보다 낮다고 함.
Per-Question-Best는 각 질문마다 가장 잘 맞춘 모델의 답을 골라서 합친 것임. 즉 모델의 잠재력으로 볼 수 있는데, RLPR빼고 Trinity가 잠재력에 근접함.
4.3 Zero-shot Transfer to Unseen Tasks
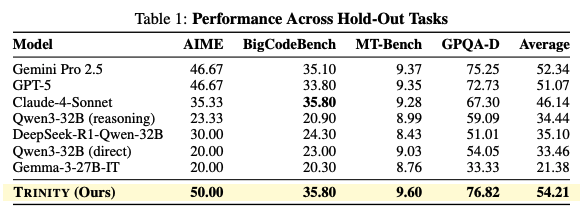
TRINITY는 가장 높은 평균 점수(54.21)를 달성 네 가지 태스크 각각에서 모든 개별 baseline 모델을 능가.
개별 모델들이 특정 분야에서 강점과 약점을 보이는 것과 달리(예: Gemini Pro 2.5와 GPT-5는 코딩보다 추론 태스크에서, Claude-4-Sonnet은 비교적 균형 잡힌 성능), TRINITY는 모든 도메인에서 일관된 결과를 보임.
4.4 Unleashing Full Power
공정한 비교를 위해 모든 LLM의 최대 출력 길이를 제한함. LiveCodeBench 태스크의 경우, 코디네이터의 LLM 선택이 학습 과정에서 클로즈드소스 3개 모델로 좁혀진다. 이후 출력 길이 제약을 제거하고 LiveCodeBench에서 TRINITY의 잠재력을 확인함. 단, TRINITY를 재학습하지 않고 제약만 해제하였음.
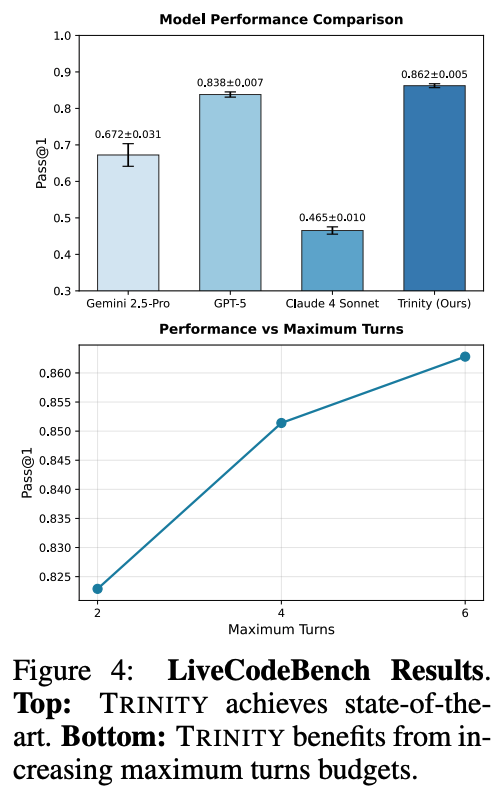
Figure 4에서 TRINITY는 구성 모델들 대비 큰 폭의 성능 향상을 보이며, LiveCodeBench V6(2025년 1~4월 신규)에서 pass@1 기준 0.862라는 성능을 달성. 또한 Figure 4(하단)에서 보이듯, TRINITY는 최대 협업 턴이 늘어날수록 성능이 향상되어 2턴에서 6턴으로 증가함에 따라 0.823에서 0.863으로 개선.
근데, coordinator의 input context는 제약있음. 만약 LLM들의 context limit을 해제하면, coordinator는 다 못읽을 수 있음.
따라서 최근의 턴들만 다룬다던가 (실험 필요), 3.2절을 보면 The coordinator extracts the key information and stores it as O_k 라고 하는데 어떤식으로 하는지는 모르겠음. 일반적으로 Compact를 하게되면 성능이 많이 떨어지는 것으로 알고 있음. 특히 코드같은 경우는 context의 양도 많고, 정보도 여기저기 흩어져 있기 때문에 turn수도 많아질 가능성이 있음. 이에 대한 고민은 필요한 부분임.
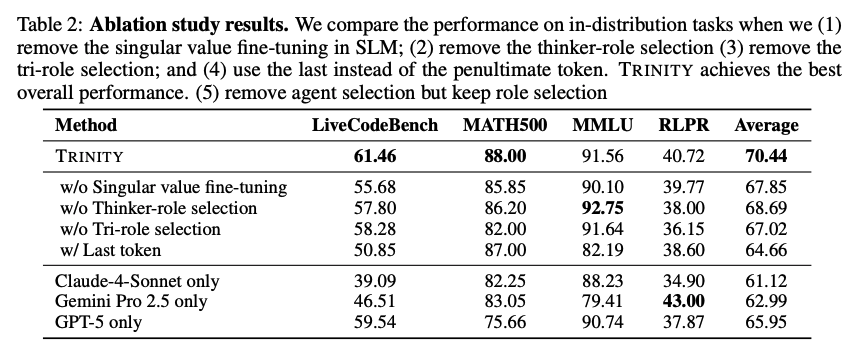
4.5 Ablation Study
특이값 파인튜닝을 제거 --> 점수가 일관되게 낮아짐 -- 코디네이터 모델의 웨이트 튜닝이 헤드에 효과적인 신호 제공
Thinker, 트라이-역할 선택을 단계적으로 제거 --> 큰 성능저하.
Penultimate을 Last 토큰으로 사용 --> 의미가 크지 않은 EOS 토큰을 사용하니 LiveCodeBench -10점 이상 급락
단일 모델 사용 --> 태스크별 최적 모델 활용 불가
결론: 위 요소들 모두 필수적이며, 하나라도 제거하면 성능이 유의미하게 하락
4.6 Separability in Representation Space
Visualization으로 분리 가능성을 보여줌. 적은 파라미터 튜닝만으로 달성이 가능
4.7 Separability in Problem Objective
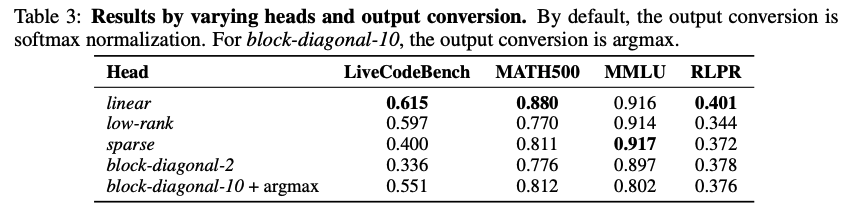
Linear 헤드가 전반적으로 가장 안정적 --> 전 벤치마크에서 최고 성능
Block-diagonal-10 + argmax 설계 의도 --> 10개 로짓(에이전트/역할당 1블록) 간 독립성 최대화, 블록 간 상관관계 억제
파라미터 효율성 --> Block-diagonal-10은 linear 대비 파라미터 10배 적음 (1,024 vs 10,240)에도 경쟁력 있는 성능 유지
argmax의 역할 --> softmax의 확률 재분배 제거 --> 다른 logit의 확률이 올라가면 상대적으로 다른게 내려감 --> 신호체계가 비 일관적임 --> 반면 argmax를 사용하면 블록 간 간섭 없음. (argmax사용시 미분 불가능한데, Trinity의 weight update은 backpropa로 하는게 아님)
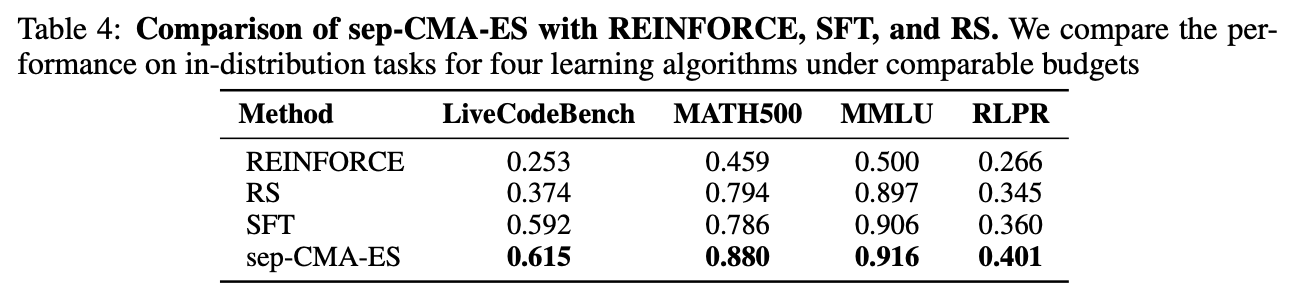
4.8 SEP-CMA-ES vs Random search vs Reinforce vs SFT
REINFORCE는 마지막 답변의 이진 보상과, 약한 파라미터 상관관계 하에서 --> 불규칙하고 분산이 큰 학습 곡선 --> 낮은 성능을 보임.
근본적으로 backpropagation이 안되기 때문에 강화학습이 작동안한것임. (복습 역전파를 못한이유는 API 사용하기 때문)
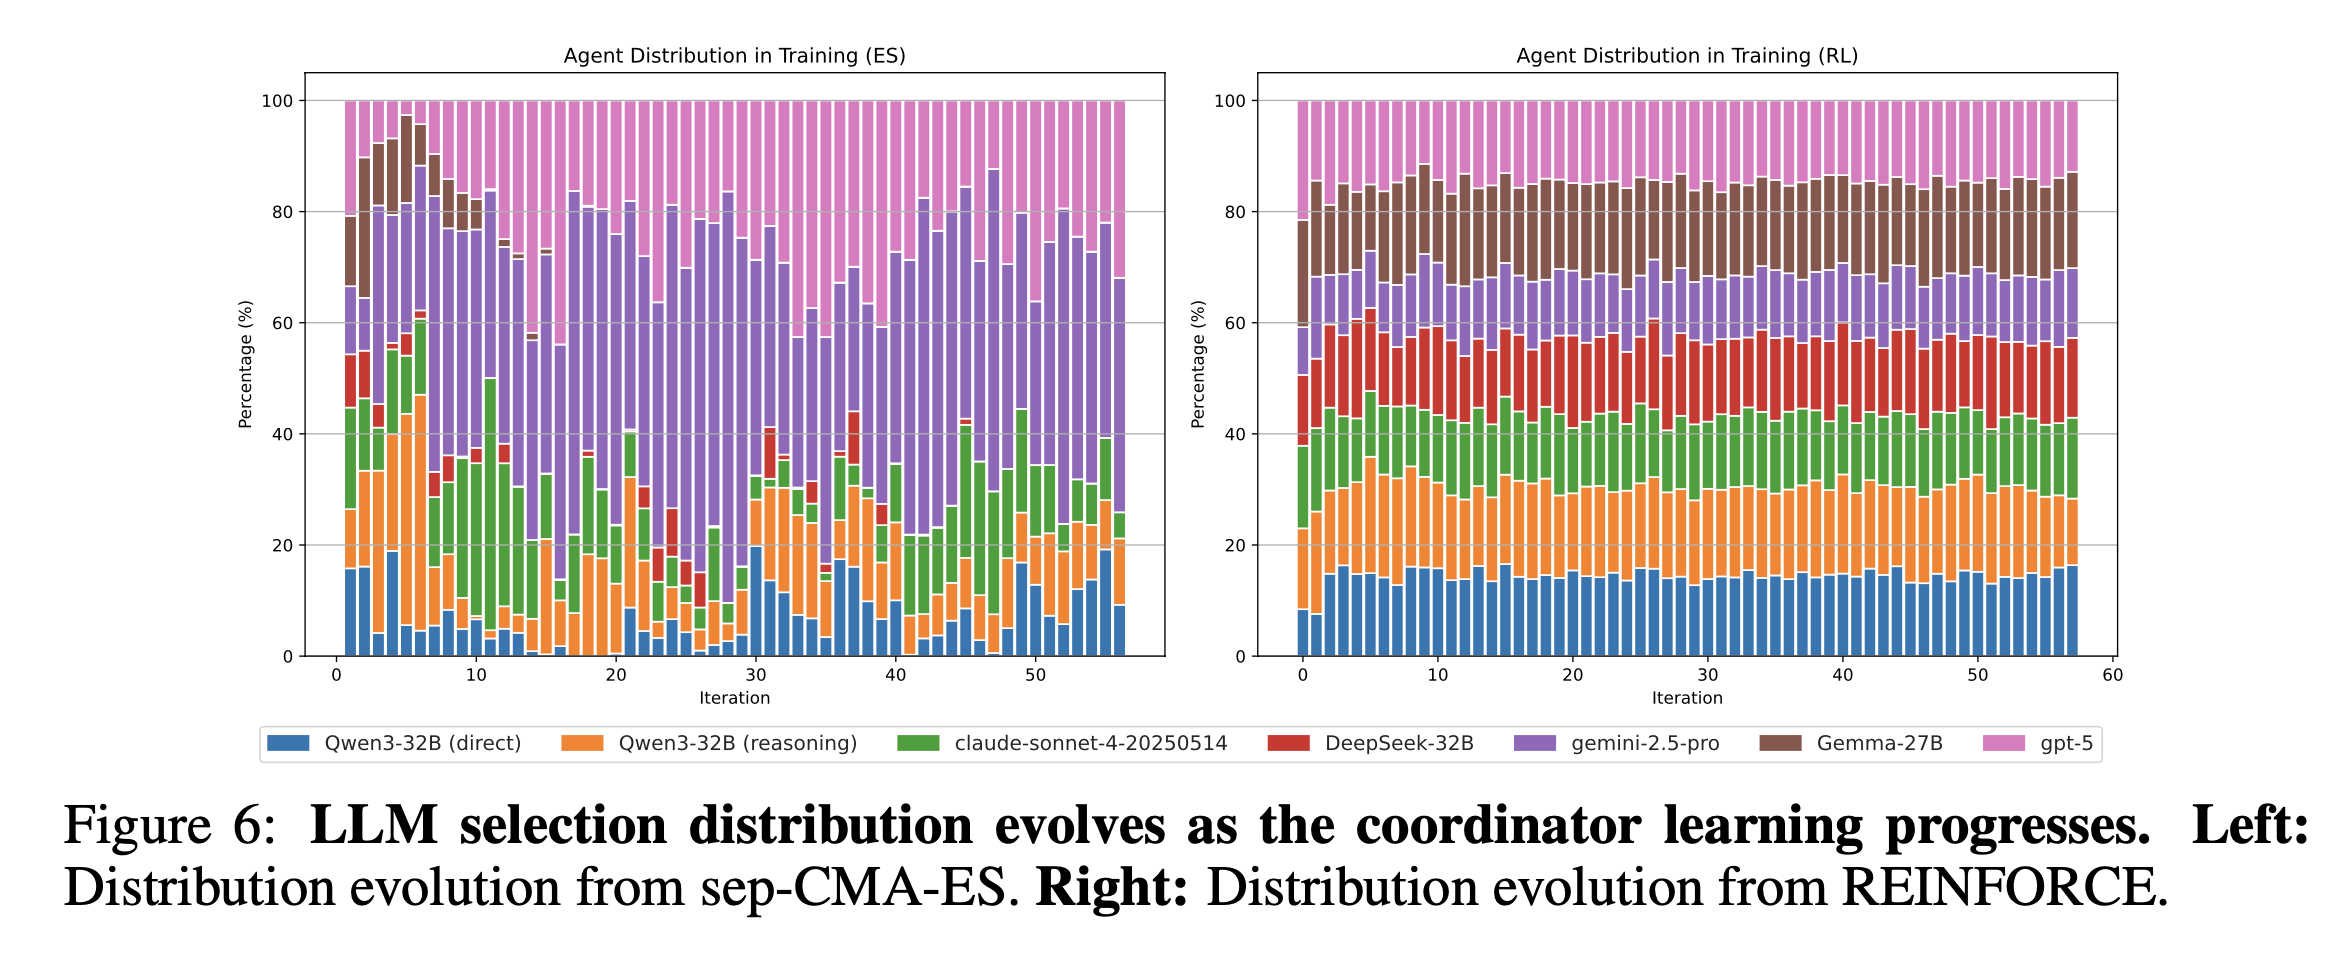
Figure 6 - sep-CMA-ES는 성능이 높은 LLM을 선호 분포로 학습한다.
반면 REINFORCE는 거의 균등 선택 패턴을 유지 --> 학습이 안되는 것을 볼 수 있음.
[학습 단계] 입력 영상 (5분, 25FPS, 512×512) + 오디오 ↓ Stage 1 (Canonical Stage): 정적인 평균 얼굴 형태 학습 ↓ Stage 2 (Deformation Stage): 오디오에 따른 변형 학습
[추론 단계] 새로운 오디오 → 변형 예측 → 3DGS 렌더링 → 출력 영상 (120FPS)
[학습 전] triplane = 랜덤값 (아무 의미 없음) Gaussian 위치 μ = 3DMM 메쉬 버텍스 (초기값)
[학습 중 - 6000 프레임 반복] triplane → f(μ) 추출 → MLP → s, r, SH, α 예측 → 렌더링 → 실제 프레임과 비교 (loss) → triplane, MLP 가중치 업데이트
[학습 후] triplane = 이 사람 얼굴의 3D 공간 정보가 담긴 파라미터 → 어떤 μ를 넣어도 그 위치의 올바른 Gaussian 속성이 나옴
# 학습 루프

# triplane = 학습 파라미터 (처음엔 랜덤값)
triplane = nn.Parameter(torch.randn(3, 64, 64, 64))

for frame in training_video:

    # 1. triplane에서 각 Gaussian 위치의 특징 추출
    f = extract_feature(triplane, gaussian_positions)  # [N, 64]

    # 2. MLP로 Gaussian 속성 예측
    s, r, SH, alpha = F_can(f)

    # 3. 이 Gaussian들로 현재 카메라 시점 렌더링
    predicted = render(gaussians, camera[frame])

    # 4. 실제 이미지와 비교 → loss
    loss = L1(predicted, real_image[frame])

    # 5. loss 역전파 → triplane 파라미터 업데이트
    loss.backward()
    optimizer.step()
    # ↑ 여기서 triplane 값들이 조금씩 수정됨
0. Abstract
실시간으로 포즈 제어가 가능한 talking head를 생성하는 새로운 프레임 제안.
3D Gaussian Splatting(3DGS)의 빠른 렌더링 능력을 활용, 음성 오디오로 --> 3DGS를 직접 제어의 어려움 해결
canonical 3DGS 표현을 구성, 이를 오디오에 맞춰 변형
핵심 아이디어: 3D Gaussian의 속성들을 shared implicit feature 표현으로 인코딩
이 표현은 오디오 feature와 결합되어 각 Gaussian 속성을 조작하는 데 사용.
이 설계로 triplane은 공간 인식 feature를 학습할 수 있으며
2D feature grid의 보간(interpolation) 메커니즘을 통해 인접한 점들 사이의 상호작용을 자연스럽게 함.
추출된 feature embedding은 이후 spatial-audio attention 모듈로 전달되어, 오디오 feature와 융합된 뒤 각 Gaussian 속성의 프레임별 offset을 예측
1. Introduction
talking head활용: 디지털 휴먼, 가상 아바타, 영화 제작, 화상 회의 등
한계: 대부분 머리 포즈 제어에는 초점을 맞추지 않아 현실감과 활용도에 한계가 있음.
최근: 포즈 제어가 가능한 talking portrait를 만들기 위해 Neural Radiance Field(NeRF)를 적용한 연구들이 다수 등장. 이 방법들은 NeRF의 MLP에 오디오 feature를 직접 conditioning함으로써, 입력 오디오에 맞게 입술이 동기화된 3D 머리 구조를 시점 일관성 있게 합성할 수 있음.
장점: 이러한 NeRF 기반 기술들은 높은 품질과 일관된 시각적 결과물을 만들어냄
단점: 느린 추론 속도.
최근 연구들이 512×512 해상도에서 최대 30 FPS의 렌더링 속도를 달성하긴 했으나, 실제 서비스에 적용하려면 여전히 계산 병목을 넘어서야 한다.
한계 극복하는 제안된 방법: 3D Gaussian Splatting(3DGS)의 빠른 렌더링 능력을 활용.
3DGS는 최근 NeRF의 실질적인 대안으로 주목, 비슷한 렌더링 품질을 유지하면서도 추론 속도를 크게 향상.
3DGS는 원래 정적인 3D 장면 재구성을 위해 제안되었지만, 이후 연구들이 동적 장면으로 확장했다.
단점: 활용하는 연구는 아직 부족하며, 대부분은 FLAME 같은 중간 메쉬 표현을 사용, 중간 3D 메쉬 표현에 의존한 변형은 머리카락이나 얼굴 주름 같은 세밀한 디테일을 표현하는 데 한계가 있다.
다른 어려움: 음성 오디오를 3D Gaussian의 변형에 직접 매핑하는 데는 두 가지 핵심 어려움이 있다.
첫째, 3DGS 표현은 인접한 점들 사이의 공간 정보를 공유하지 않음 (시간적 관계도 자체적으로 들어가있지는 않음 --> 음성에 의존함)--> 조작이 까다롭다.
3DGS의 최적화 과정은 이웃한 Gaussian들 사이의 관계를 고려하지 않는데, 이 관계는 변형 중에 얼굴 영역의 일관성을 유지하는 데 매우 중요.
둘째, 방대한 파라미터 공간과 많은 수의 Gaussian이 조작을 어렵게 만든다. 샘플링 점의 위치와 수가 고정된 NeRF 표현과 달리, 수많은 Gaussian 점들의 위치·형태·외관 속성을 매 프레임마다 변형하면서도 복잡한 얼굴 디테일을 보존해야 한다.
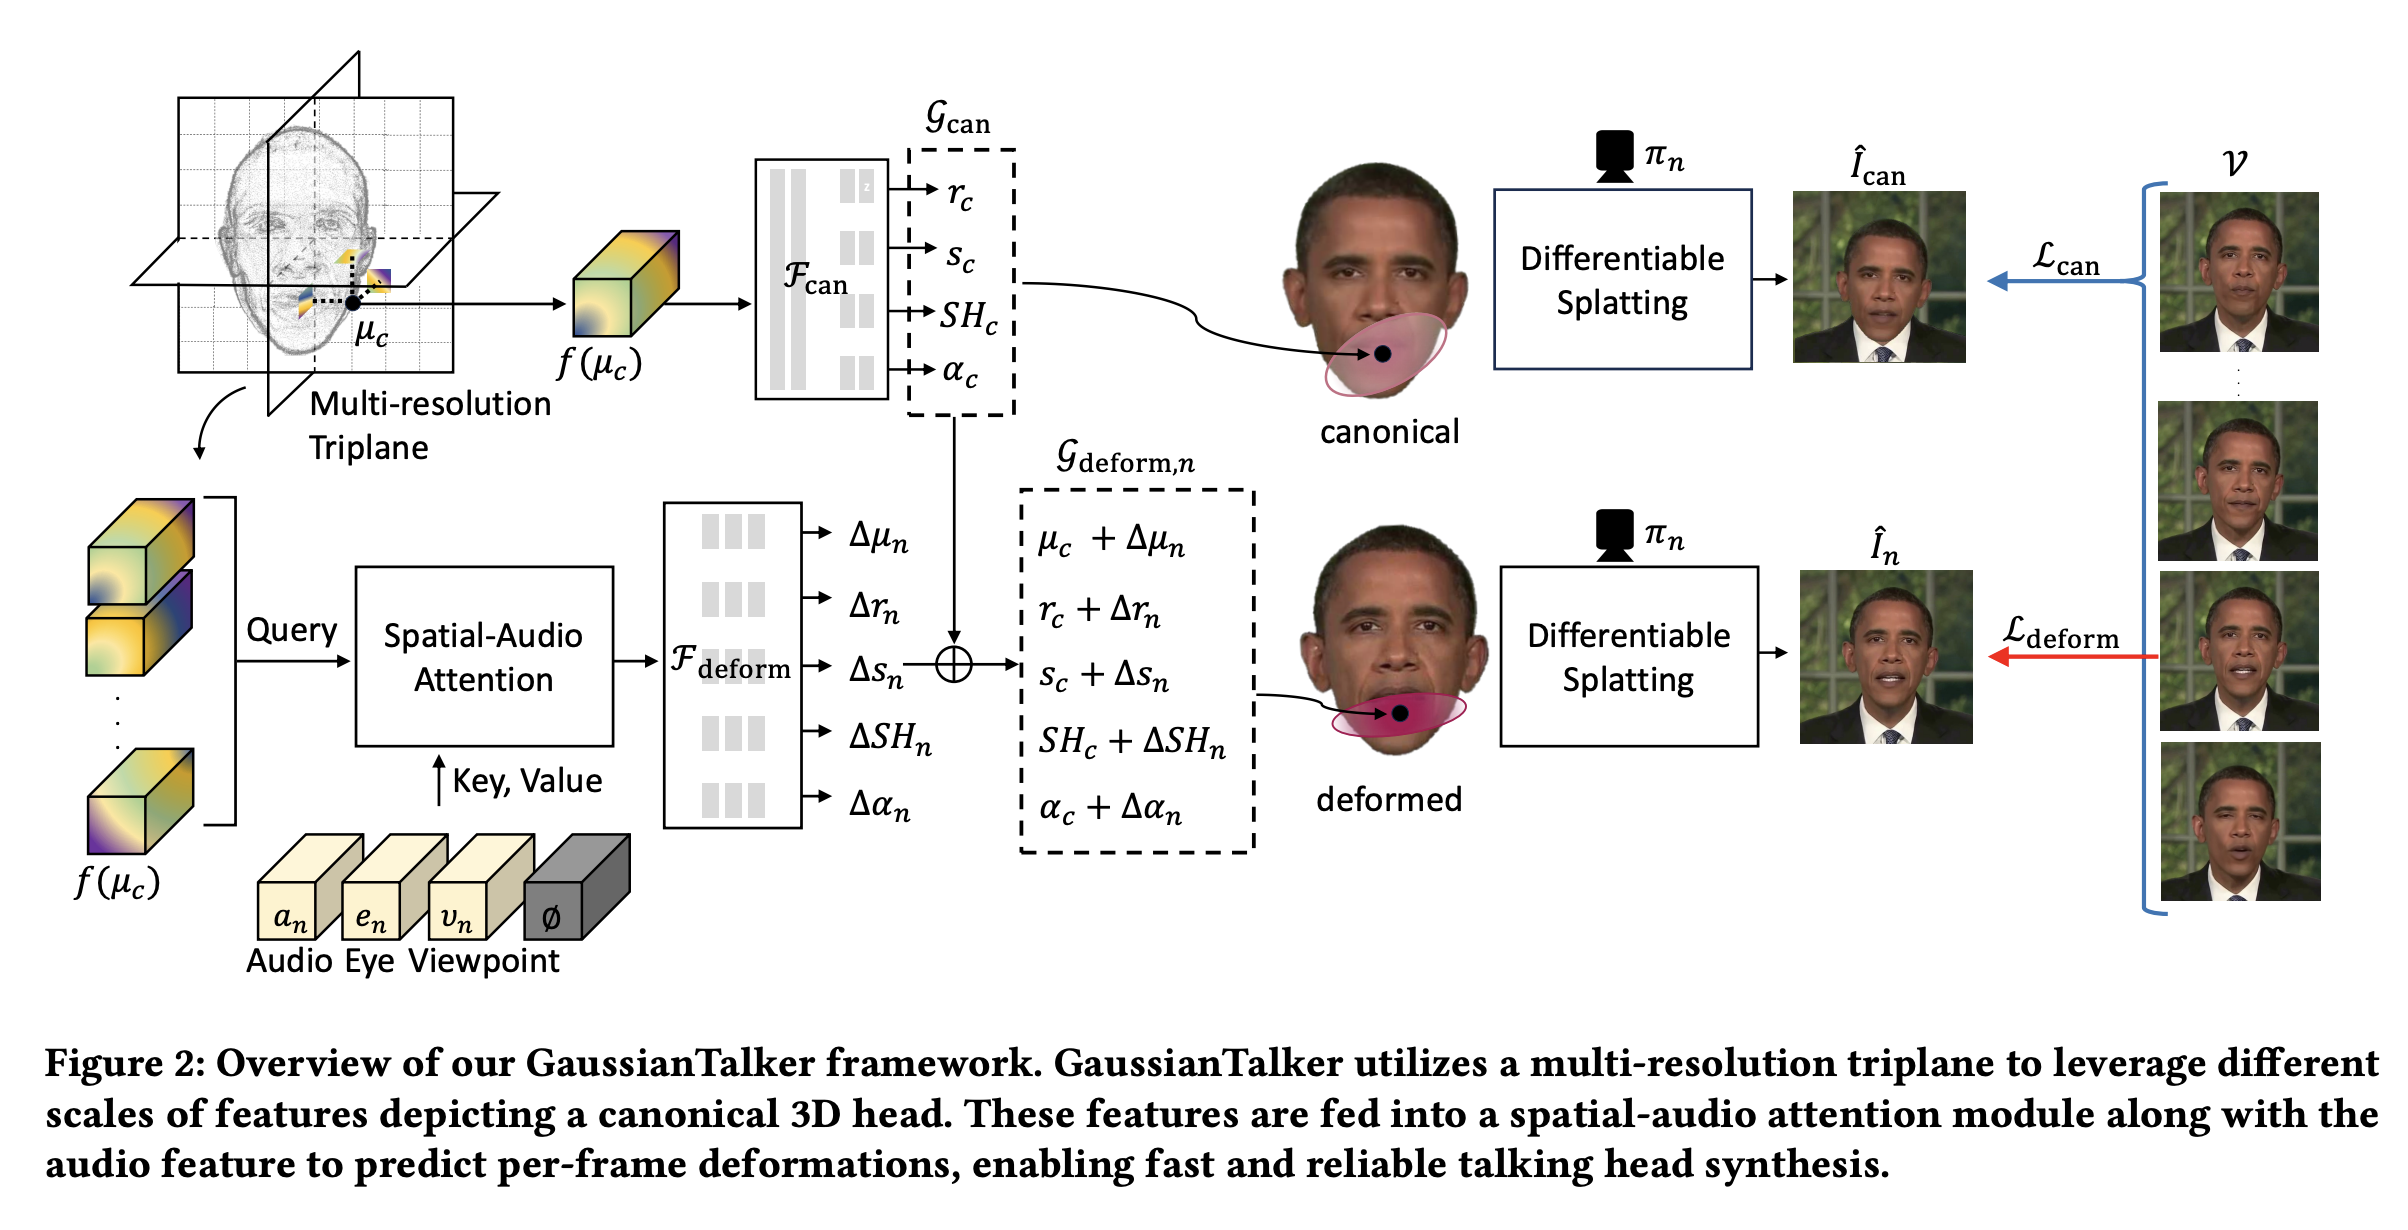
이 논문에서는 실시간 포즈 제어 가능한 talking head 합성을 위한 새로운 프레임워크GaussianTalker를 제안한다. 최초로 3D Gaussian 표현을 활용하여, 오디오 기반 --> 애니메이션에 모델링 능력을 적용.
먼저 canonical 머리 형태의 정적 3DGS 표현을 구성하고, 이를 오디오에 맞춰 변형.
multi-resolution triplane을 사용: 각 3D Gaussian 위치의 feature embedding을 추출하기 위해 --> 이로부터 각 Gaussian 속성을 직접 추정
(frame --> triplane) 학습: triplane은 3D 머리의 공간적·의미적 정보를 학습. 이때 triplane은 Grid인데, 연속형인 가우시안으로 하기 위해, 예측된 triplane의 주변 점들의 평균으로 interpolate을 함.
feature embedding은 spatial-audio attention 모듈로 전달되어 오디오 feature와 융합되며, 각 Gaussian 속성의 프레임별 offset을 예측.
Cross-attention: 이 모듈은 오디오 feature와 각 Gaussian의 사이의 연관성을 성공적으로 학습.
정리: Gaussian이 독립적으로 작용하는 단점을 Triplane을 공유하는것으로 극복
Gaussian의 속성을 독립적으로 저장하는 대신, Triplane이라는 공유된 공간에서 뽑아씀
3D 가우시안(타원형 공)의 모양이 찌그러지거나 수학적으로 말도 안 되는 형태가 되지 않도록, $\Sigma$을 크기(S)와 회전(R)이라는 직관적인 물리량으로 나누어 계산한다.
여기서 R은 q에서 변형됨: 쿼터니언 $q = [w, x, y, z]$는 w=cos(θ/2), x=uxsin(θ/2), y=uysin(θ/2), z=uzsin(θ/2)임.
컴퓨터가 3D 점들을 실제로 회전시키려면3×3행렬 형태의 연산자가 필요
아래의 식에 각 값을 대입하여 3*3 행렬을 만듬, 아래식은 R임. [ 1-2(y²+z²), 2(xy-wz), 2(xz+wy) ] [ 2(xy+wz), 1-2(x²+z²), 2(yz-wx) ] [ 2(xz-wy), 2(yz+wx), 1-2(x²+y²) ]
$\Sigma => RSS^TR^T$
[3x3] = [3x3] [3x3] [3x3] [3x3]
구체적 설명: 각각은 S(스케일 벡터), 단위 쿼터니언 q로 파라미터화 된다. $s \subseteq R^3, q \subseteq R^4$
자세한 설명
타원체의 중심에서 바깥쪽으로 갈수록 가우시안 확률(투명도)이 낮아져야 함 --> 이 확률이 정상적인 값을 가지려면, 거리를 계산하는 핵심 축인 공분산 행렬의 모든 고윳값(Eigenvalue)이 0 이상(양수)이어야 함.
AI가 학습하면서 $\sum_{}^{}$행렬의 숫자들을 직접 마구잡이로 수정하게 놔두면, 앞서 말한 양의 준정치 조건이 쉽게 깨짐.
임의의 행렬에 자기 자신을 전치(Transpose)한 행렬을 곱하면 --> 그 결과물은무조건 수학적으로 양의 준정치 행렬이 됨
모델이 예측하는것은 q,R임. Not directly predicting $\Sigma$
또한, 외관 정보를 담기 위해 차수 k의 구면 조화 함수(Spherical Harmonics) 계수 $c \subseteq R^{3(k+1)^2}$와 불투명도(opacity) 값 $\alpha \subseteq R$를 함께 가짐.
구조화 함수: 3D 가우시안은 가만히 멈춰 있는 그림이 아니라, "왼쪽에서 볼 때와 오른쪽에서 볼 때 색상이나 반사광이 달라지는 성질"을 표현해야함. 구면 조화 함수는보는 각도(구면 위의 위치)에 따라 색상이 어떻게 변하는지 수학적인 함수들의 합으로 표현
k=0(기본 베이스색):방향에 따른 색상 변화가 전혀 없는 상태. 어느 방향에서 보든 똑같은 단색(무광)으로 보임
k=1(부드러운 음영):빛이 한쪽에서 비출 때 발생하는 은은하고 부드러운 음영이 표현되기 시작
k=2,3(정교한 하이라이트):머리카락의 윤기, 뺨에 맺히는 하이라이트, 보는 각도에 따라 번뜩이는 세밀한 질감과 반사광까지 정교하게 표현할 수 있음.
차수k가 올라갈 때마다 필요한 함수의 개수가 제곱((k+1)2)으로 늘어남. 빛의 삼원색인 RGB(3개 채널)를 각각 표현해야 하므로 앞바퀴에3이 곱해짐.
정리: 3DGS는 하나의 3D장면을 다음과 같은 파라미터들의 집합으로 표현함
$g = {\mu, q, s, c, \alpha}$ (예측해야 할 것)
새로운 시점이($\pi$) 주어질 경우 2D이미지 $\hat{I}$는 다음과 같이 렌더링 됨
$\hat{I} = R(g; \pi)$
여기서 $R$은 미분 가능한 래스터라이저라고 함.
새로운 시점을 렌더링시 미분 가능한 splatting을 사용. 3D Gaussian --> 2D로 투영시, 3D공간의 공분산을 2D공간의 공분산으로 변환해야함.
W(뷰 변환 행렬): 카메라가 세상을 보는 방향을 수학적으로 표현 <-- 계산은 외부 파라미터로 계산 (COLMAP)으로 계산함. COLMAP에서 여러 프레임에서 공통으로 보이는 특이점들을 추적함. 각 프레임의 카메라 위치/방향을 역산함. 이 논문에서는 3DMM을 사용함.
J(야코비안 행렬): 3D --> 2D 투영시 변환은 비선형 함수임. 근데 공분산 변환은 선형 변환만 가능함. 이것을 야코비안이 가능하게함. 수학적으로는 복잡함.
Stage1: Canonical Stage - 이 사람의 평균적인 얼굴 형태를 3DGS로 만들기
# 렌더링
# ↓ 입력: G_can + 카메라 파라미터 W, f (사전준비에서 구한 것)

# 1. 각 Gaussian을 2D로 투영
J      = jacobian(μ_c, f)           # 해당 점의 깊이와 초점거리로 계산
Σ'     = J @ W @ Σ_c @ W.T @ J.T   # 2D 공분산

# 2. 현재 시점으로 SH → 실제 색상 변환
c_i    = SH_to_color(SH_c, view_direction)

# 3. 알파 계산
α'_i   = α_c * gaussian_2d(Σ')

# 4. 픽셀 색상
C      = Σ c_i * α'_i * Π(1 - α'_j)   # 렌더링 공식

# 손실
L_can  = L1(C, C_gt) + λ_lpips * LPIPS(C, C_gt) + λ_dssim * DSSIM(C, C_gt)
#                              ↑ C_gt = 실제 영상 프레임
Stage2: Deformation: 오디오가 주어졌을 때 G_can을 어떻게 변형할지 학습
[입력 출처 정리]

f(μ_c)    : Stage 1에서 학습된 triplane으로 추출  (고정)
a_n       : 사전 준비에서 추출한 오디오 특징      (고정)
e_n       : 사전 준비에서 추출한 눈 깜빡임 특징   (고정)
v_n       : W_n (카메라 포즈)을 MLP에 통과시켜 추출
            (MLP_viewpoint는 학습 파라미터)
∅ (null)  : 학습되는 벡터 파라미터 (1개, 전 프레임 공유)
# Spatial-Audio Cross-Attention
z_0 = f(μ_c)                                    # [N, 64]  초기값
conditions = concat([a_n, e_n, v_n, ∅])         # 4가지 조건

for l in range(L):                               # L=2 레이어
    z' = CrossAttention(query=z,
                        key=conditions,
                        value=conditions) + z    # skip connection
    z  = FFN(z') + z'                            # skip connection

z_L = z   # [N, 64]  오디오 정보가 녹아든 Gaussian별 특징
# CrossAttention, FFN 전부 학습 파라미터
# Stage 1과 동일한 렌더링 과정, G_deform으로
Σ      = R(q_c+Δq) @ diag(s_c+Δs) @ ...   # 새로 계산
Σ'     = J @ W @ Σ @ W.T @ J.T
c_i    = SH_to_color(SH_c + ΔSH, view_direction)
α'_i   = (α_c + Δα) * gaussian_2d(Σ')
C      = Σ c_i * α'_i * Π(1 - α'_j)

# 손실 (Stage 1 손실 + 입술 영역 추가 손실)
L_deform = L_can + λ_lip * L1(C_lip, C_lip_gt)
#                              ↑ 입술 부분만 크롭해서 추가로 계산
4. Methodology
4.1 Problem formulation and Overview
목적: GaussianTalker는 오디오 입력을 기반으로 고화질의 pose 제어 가능한 talking head 이미지를 실시간으로 합성
학습 데이터: 특정 인물의 talking portrait 영상 $V = {I_n}$ (총 N개의 프레임)
목표:
특정 인물의 평균적인 머리 형태를 표현하는 canonical 3D Gaussian 집합을 복원
입력 오디오에 맞게 이 3D Gaussian들을 변형시키는 deformation 모듈을 학습하는 것
추론 시:
입력 오디오 a_n이 주어지면, deformation 모듈이 각 Gaussian attribute의 offset을 예측하고, 변형된 Gaussian들을 시점(viewing point) π_n에서 rasterize하여 최종 이미지 Î_n을 출력
4.2 Learning canonical 3D Gaussians with triplane representation
3DGS --> 인접한 Gaussian들 사이의 공간적 관계를 본질적으로 포착하지 못함.
이상적인 feature 표현은, 가까운 얼굴 부분은 유사하고 멀리 떨어진 영역끼리는 달라야 한다. 얼굴에서 인접한 점들은 같은 방향으로 움직일 가능성이 높기 때문임.
이 논문에서는:
3D Gaussian 표현을 저차원 feature 표현을 학습하는 방식으로 수정. ($F_{can}$)
이 feature는 이후 오디오 feature와 합쳐져 각 Gaussian의 deformation을 계산하는 데 사용.
4.2.1 Triplane representation for 3D Gaussian
Embedding space: $f(\mu_c)$인데, 여기서 $\mu$는 tri-plane인 (xy, yz, zx)이고, 각 그리드 좌표는 --> nn.Parameter(torch.randn(feature, 좌표, 좌표))로 맵핑됨. --> Gaussian들 사이의 공통 임베딩 차원으로, Gaussian들관의 연관성도 고려한다고 함 (근데 명시적으로 연관성을 고려하지는 않는데,, 학습이 그렇게 잘 될까 싶음) ### xy, yz, zx weight vector가 따로 있어야함.
학습 가능한 그리드 좌표 선언: xy,yz,zx각각 = nn.Parameter(torch.randn(feature, 좌표, 좌표))
전체 가우시안들의 $\mu$들의 좌표를 [0,R)로 정규화. 진짜 세계(World) 좌표계에서 3D 가우시안의 위치μ는[-2.5, 1.2, 0.4]같은 아주 자유로운 실수 값 --> 반면, 선언한 Triplane(바둑판 지도)은 가로, 세로 칸 수가R개(예:R = 64칸)로 딱 정해져 있음.
예) 진짜 3D 세계의 경계가[-2.0]부터[+2.0]까지라고 가정. 바둑판 해상도는R=64. 어떤 가우시안의 좌표가μ=[0.0,1.0,−2.0]이라면 [0, 64) 범위로 정규화(Mapping): x=0.0은 정중앙이므로→32.0번째 칸 ...
Interpolation하여 feature 계산 f_xy = F.grid_sample(P_xy, query_grid, mode='bilinear', padding_mode='zeros', align_corners=True) --> P_xy와 가까운 네 꼭지점에 있는 feature들의 가중평균을 f_xy의 feature라고 한다.
각 평면의 feature는 Hadamard product(⊙)로 결합 --> $f_xy⊙f_yz⊙f_zx$: element wise product
서로 다른 차원에 걸쳐 concat(⌣): 각 canonical Gaussian 위치 μ_c에 대한 길이 H의 최종 feature 벡터 f(μ)를 생성. 갑자기 다른 차원 이야기가 나온다. --> Appendix(A.1) 코어 아이디어는 같은 triplane을여러 해상도로 만들어서 각각에서 feature를 뽑고 합치는 것
추측(정확한 내용은 코드를 살펴봐야함):
지금은 낮은 해상도 (64)로 하였지만, 예를들어 (128)짜리 plane을 하나 더 만든다. 예) nn.Parameter(torch.randn(1, 32,64,64)) [batch, feature, plane, plane] nn.Parameter(torch.randn(1, 32, 128, 128)) [batch, feature, plane, plane]
각각의 해상도에서 interpolate함.
그리고 concat함 --> 64 feature의 벡터
$\mu_c: canonical Gaussian의 3D 위치 좌표 (x, y, z)$
$f(\mu_c): 그 좌표를 triplane 세 평면에 투영해서bilinear interpolation으로 뽑아낸 feature 벡터$
4.2.2 Attribute prediction of canonical 3D Gaussians
장점: implicit feature 차원에서 뽑아내기에, feature들이 훈련이되면 가우시안들이 각각 독립적이지 않고 얼굴 정보를 공유함.
4.3 Learning audio-driven deformation of 3D Gaussians
기존 연구: conditional NeRF 표현 사용. 이 방식에서는 각 광선 위 sampling point의 3D 좌표가 고정된 채로, 색상과 밀도만 입력 오디오에 따라 달라짐.
이 논문: 3D Gaussian 자체를 변형하는 방식을 선택. 외관 정보뿐만 아니라 각 Gaussian primitive의 공간적 위치와 형태까지 직접 조작한다. 이 방식이 끊임없이 변화하는 talking head의 3D 형태를 더 정확하게 포착할 수 있지만, NeRF보다 복잡한 작업임.
Gaussian 파라미터의 복잡성은, 광범위한 파라미터 공간으로 인해 deformation(변형)에 상당한 어려움을 초래한다. 게다가 입력 오디오가 얼굴 전체 이미지에 균일하게 영향을 미치지 않기 때문에, 자연스러운 얼굴 애니메이션을 위해서는 deformation 모듈이 얼굴의 각 영역이 오디오 조건에 어떻게 반응하는지 이해하는 것이 매우 중요함.
구체적인 방법
논문에서 오디오 형태를 어떻게 변환하는지는 나오지 않음. (AD-NeRF, ER-NeRF)의 경우 DeepSpeech, wav2vec을 씀.
wav2vec이라고 가정 (구체적인것은 코드를 봐야함)
Query: $f(\mu)$ - 이미 학습된 triplane에서 모든 가우시안 중심점 $\mu$에 해당하는 feature들 (1, 64, 50000, 1)→squeeze→(1, 64, 50000)→permute→(1, 50000, 64) [batch, # gaussian, feature]
Talking head를 합성할 때, 입력 오디오가 얼굴의 모든 복잡하고 다양한 움직임을 설명하지는 않는다. 눈 깜빡임이나 얼굴 주름 같은 미묘한 표정, 그리고 머리카락 움직임이나 조명 변화 같은 외부 요인들은 입력 음성 오디오와 직접적인 연관이 없다. 따라서 음성 오디오를 3D Gaussian deformation으로 매핑할 때, 비언어적 움직임과 장면 변화를 분리하는 것이 중요.
기존 연구들을 따라,
e_n - eye feature e: 명시적인 눈 깜빡임 제어를 적용 - Facial Action Coding System의 AU45를 사용하여 눈 깜빡임 정도를 나타냄 프레임 1: AU45 = 0.0 # 눈 뜸 프레임 2: AU45 = 0.0 프레임 3: AU45 = 0.3 # 깜빡이기 시작 프레임 4: AU45 = 0.9 # 거의 감김 프레임 5: AU45 = 1.0 # 완전히 감김 프레임 6: AU45 = 0.2 # 다시 뜨는 중 프레임 7: AU45 = 0.0 # 완전히 뜸
추가적으로 입력 차원을 맞추기 위해 sinusoidal positional encoding을 활용.
v_n - 카메라 시점을 보조 입력: 비언어적 장면 변화를 분리. 쉽게 풀어 작성하면, 프레임1, 프레임2에서 모두 "아"라고 소리를 내도. 영상이 달라보임. 프레임1에서는 정면을 보며 말하다가, 프레임2에서는 왼쪽으로 돌려서 말함. 오디오만 조건으로 사용하게 되면, 신경망 입장에서 같은 "아" 소리인데 왜 영상이 다르게 보이는지 혼란스러워 할 수 있음. --> 립싱크 품질 저하 따라서, extrinsic camera matrix이라는것을 계산해서 모델에 같이 입력으로 넣어주면, (카메라 <--> 얼굴) 방향에 따라 다르게 보일 수 있겠구나를 학습하고자함. extrinsic camera matirx는 3DMM fitting으로 계산됨.
null-vector(∅): 모든 프레임에 걸쳐 단일 null-vector(∅)를 사용하면 영상 프레임 전반에 걸친 전역적 일관성을 유지하는 global feature로서 효과적임을 발견.
delta값들이 작을수록 좋은 설계임. 왜냐하면: canonical = 평균적인 얼굴 형태 (입 다문 상태) delta = 이번 프레임에서의 변화량 (입이 얼마나 벌어지는가)
delta가 작으면 → 모델이 canonical에서 크게 벗어나지 않아도 됨 → 학습이 안정적 → 얼굴 정체성(identity)이 유지됨
4.4 Training
4.4.1 Stage-wise optimization
초기화의 중요성
좋은 초기화: 얼굴 근처에 Gaussian이 있으니 조금만 최적화해도 빠르게 수렴함.
기존 3DGS는 Structure from Motion이라는 것으로 초기화함.
장점: 정적인 장면에서 잘 작동함
단점: 근데 얼굴은 계속 움직임
이 논문에서 초기화 방법: 3DMM
학습 영상의 각 프레임 ↓ 3DMM fitting (Basel Face Model 등) ↓ 두 가지를 동시에 얻음 ├── 카메라 파라미터 (extrinsic matrix) → v_n으로 사용 └── 메쉬 vertex 좌표 (~수만 개의 3D 점) ↓ Gaussian 초기 위치로 사용
그리고 3DMM은 이미 얼굴 형태를 알고있음.
또한 3DMM은 필수적임, 왜냐하면 카메라 파라미터를 구하려면 3DMM이 필수적임.
4.4.2 Loss Functions
1단계: Canonical Stage - 평균적인 얼굴 형태(canonical)를 잘 복원하는 것을 목표로함. 학습하는 것: ① Gaussian 위치 μ_c ② Multi-resolution triplane
학습 방법: 모든 프레임의 평균적인 모습을 재구성
결과물: G_can = {μ_c, r_c, s_c, SH_c, α_c} → 입 다문 상태의 평균 얼굴
목적: 어떤 시점에서든 얼굴을 렌더링 하고 싶음. Gaussian들은 3D 공간에 고정되어 있고, 카메라가 어디로 이동하든 W와 d만 바꿔서 렌더링 하면 됨. <-- NeRF와 비교했을 때 강점.
고정 (학습 전에 이미 앎): ├─ 카메라 Extrinsic (C, R) ← 3DMM 피팅으로 프레임마다 추정 └─ world_up = (0,1,0) ← 가정
학습으로 결정: ├─ Gaussian 위치 μ ← 3DMM 메쉬 버텍스로 초기화 후 학습 ├─ Gaussian 크기 s ← 학습 ├─ Gaussian 회전 r ← 학습 ├─ Gaussian 불투명도 α ← 학습 └─ SH 계수 (48개) ← 학습
μ (위치): (x,y,z)좌표 - 50,000개의 가우시안이 있다고 가정, 입술을 표현하는 가우시안은 μ가 입술 위치에 있고, 코 표현 가우시안은 μ가 코 위치에 있음
s (크기/scale): 얼마나 퍼져있나 - 타원이기에, 3축 방향으로 각각 다른 크기를 가짐 # sx=5, sy=1, sz=1 → 가로로 납작하게 퍼진 타원체 (피부 표면 같은 것) # sx=1, sy=8, sz=1 → 세로로 긴 타원체 (머리카락 한 가닥 같은 것) # sx=2, sy=2, sz=2 → 거의 구에 가까운 형태
r (회전): 공이 어느 방향으로 기울었나 - 4개의 값으로 표현함. - 쿼터니언
α (불투명도): 얼마나 투명하게 보이나 - 머리카락이나 반투명한 피부 같은 것을 표현할 때 핵심.
SH (구면조화함수): 보는 방향에 따라 색이 어떻게 달라지나 - 단순히 색(RGB) 하나를 저장하는 게 아니라,방향별로 다른 색을 저장
단순 색 저장 방식 (RGB): color = [R, G, B] # 어느 방향에서 봐도 같은 색
SH 방식: - 정면에서 보면 밝은 갈색, 측면에서 보면 어두운 갈색, 방향에 따른 색 변화를 함수로 저장 SH_coefficients = [c00, c10, c11, c12, c20, c21, ...] # 48개 계수 # → 어떤 방향 θ,φ로 봐도 그 방향의 색을 계산 가능
쿼터니언: 공이 어느 방향으로 기울었나 - 4개의 값으로 표현함.
픽셀 하나가 RGB로 만들어지는 과정 - 알파 블랜딩
카메라 방향 벡터 d = (dx, dy, dz)가 주어지면 SH에서 --> RGB를 구할 수 있음.
카메라 위치/방향 (입력)
        │
        ├──→ W 행렬: "이 Gaussian이 카메라 기준으로 어디 있나?" (투영용)
        │
        └──→ d 벡터: "카메라가 이 Gaussian을 어느 방향으로 바라보나?" (색상용)
                          │
                          ↓
                    SH_coeffs · Y(d) = RGB


# 하나의 Gaussian이 가진 SH 계수 (48개, R/G/B 각 16개)
SH_coeffs_R = [c0, c1, c2, ..., c15]  # 16개
SH_coeffs_G = [c0, c1, c2, ..., c15]
SH_coeffs_B = [c0, c1, c2, ..., c15]

# 카메라가 이 Gaussian을 바라보는 방향 벡터
# (카메라 위치 - Gaussian 위치를 정규화한 것)
d = normalize(camera_pos - gaussian_pos)  # (dx, dy, dz)

# 구면조화 기저함수 Y[i]에 방향 d를 대입
# (이건 그냥 삼각함수 조합 — 외울 필요 없음)
Y = compute_SH_basis(d)  # [Y0, Y1, Y2, ..., Y15]

# 내적으로 RGB 계산
R = sum(SH_coeffs_R[i] * Y[i] for i in range(16))
G = sum(SH_coeffs_G[i] * Y[i] for i in range(16))
B = sum(SH_coeffs_B[i] * Y[i] for i in range(16))

# → 이 카메라 방향에서 본 이 Gaussian의 색
color = (R, G, B)
카메라 방향벡터 및 W
W계산
import numpy as np

# 카메라 extrinsic 정보 (이게 "입력" 전부)
C = np.array([0.0, 0.0, 3.0])       # 카메라 위치 (z=3 지점에 서 있음)
target = np.array([0.0, 0.0, 0.0])  # 카메라가 바라보는 지점 (원점)
world_up = np.array([0.0, 1.0, 0.0]) # 세상의 "위쪽" 방향 (y축이 위), 절대적인 세상 좌표

# Step 1: forward 벡터 (카메라가 바라보는 방향)
f = normalize(target - C)
# = normalize([0,0,0] - [0,0,3]) = normalize([0,0,-3]) = [0, 0, -1]
# "카메라 앞이 -z 방향"

# Step 2: right 벡터 (카메라 오른쪽)
# forward와 world_up의 외적 → 둘 다에 수직인 벡터 = 오른쪽
r = normalize(np.cross(f, world_up))
# = cross([0,0,-1], [0,1,0]) = [1, 0, 0]
# "카메라 오른쪽이 +x 방향"

# Step 3: up 벡터 (카메라 진짜 위쪽, world_up과 미세하게 다를 수 있음)
u = normalize(np.cross(r, f))
# = cross([1,0,0], [0,0,-1]) = [0, 1, 0]

# Step 4: W 행렬 조립
# 아이디어: "세상 좌표에서 카메라 좌표로" = r,u,f 축으로 투영 + 카메라 위치 보정
W = np.array([
    [r[0], r[1], r[2], -np.dot(r, C)],  # X축: 세상 점을 r방향으로 얼마나?
    [u[0], u[1], u[2], -np.dot(u, C)],  # Y축: 세상 점을 u방향으로 얼마나?
    [f[0], f[1], f[2], -np.dot(f, C)],  # Z축: 세상 점을 f방향으로 얼마나?
    [0,    0,    0,    1             ],  # 동차좌표 (계산용)
])

# -np.dot(r, C) --> 이게 없으면 카메라가 항상 원점에 있다고 가정하게 된다, 이 항이 "카메라가 원점에서 얼마나 이동해 있는가"를 보정

# 실제로 W에 Gaussian 좌표를 곱하면:
gaussian_world = np.array([1.0, 0.5, 0.0, 1.0])  # 세상 좌표 (마지막 1은 동차)

gaussian_camera = W @ gaussian_world
# → 카메라 기준 좌표로 변환됨
# "이 Gaussian은 카메라 오른쪽 1, 위 0.5, 앞 3m에 있다"
d계산
# d는 W보다 훨씬 간단
# "카메라에서 이 Gaussian을 바라보는 방향"

gaussian_pos = np.array([1.0, 0.5, 0.0])  # Gaussian의 세상 좌표
camera_pos   = np.array([0.0, 0.0, 3.0])  # 카메라의 세상 좌표

# 카메라 → Gaussian 방향 벡터
raw = camera_pos - gaussian_pos  # [−1, −0.5, 3]

# 정규화 (길이를 1로)
d = raw / np.linalg.norm(raw)    # [−0.316, −0.158, 0.949]
W: "무대 전체를 카메라 기준으로 회전/이동시키는 변환" → 50,000개 Gaussian 모두에 같은 W가 적용됨 → 결과: 각 Gaussian의 화면상 위치와 모양
d: "카메라 → 특정 Gaussian 하나를 향한 방향 벡터" → Gaussian마다 d가 다름 (위치가 다르니까) → 결과: 그 Gaussian의 이 시점에서의 색상 (SH 계산 입력)
C는 어떻게 구하나?
3DMM으로 구함.
3DMM 피팅 출력 C → 카메라 위치 (최적화로 추정) R → 카메라 방향 (최적화로 추정) ├─ R[0] = right 벡터 ├─ R[1] = up 벡터 └─ R[2] = forward 벡터
world_up → (0,1,0) 고정값 (가정) target → 실제로 따로 필요 없음. R에 이미 포함됨
# 3DMM 피팅의 핵심 로직 (단순화)

def fit_3dmm(image):
    # 1. 2D 이미지에서 얼굴 랜드마크 검출 (딥러닝 모델)
    landmarks_2d = face_landmark_detector(image)
    # → [(눈왼쪽x, y), (눈오른쪽x, y), (코x, y), ...] 68개 점

    # 2. 3D 얼굴 모델(Basel Face Model)의 랜드마크 3D 위치는 알고 있음
    landmarks_3d = basel_face_model.get_landmarks()
    # → [(x1,y1,z1), (x2,y2,z2), ...] 68개 점 (고정)

    # 3. 최적화: 어떤 C, R이면 3D→2D 투영이 landmarks_2d와 일치하나?
    C, R = optimize(
        objective = lambda C, R:
            sum_squared_error(
                project_3d_to_2d(landmarks_3d, C, R),  # 예측
                landmarks_2d                             # 실측
            )
    )

    return C, R  # ← 이게 Extrinsic
생성 방향에서 RPG가 코드를 만들 수 있었다는 건, RPG 안에 코드를 만들기에 충분한 정보가 들어있다는 뜻이다. 그러면 반대로 코드에서 RPG를 추출하면, 그 RPG는 코드를 완전히 복원할 수 있을 만큼의 정보를 담고 있다. 따라서 이해에도 충분히 쓸 수 있다
허나, 개인적으로는 둘다 이해방향 같다는 생각이 아직 강함.
SWE-bench: 버그 위치 찾기 → 이해 방향
RepoCraft: 98.5% reconstruction coverage - 이게 생성처럼 보이지만, 실제로는 RPG에서 원래 코드 엔티티를 얼마나 빠짐없이 역추적할 수 있는가를 측정. 코드를 새로 생성한 게 아니라, RPG의 노드들이원본 코드를 얼마나 커버하는지 측정한 것
RPG-Encoder:
1)Encoding: Code --> RPG Encoding. Node: 기능 설명과 코드 메타데이터를 결합 Edge: 계층 구조, 의존성(import)을 담고, 해석(byLLM), 라인번호가 있어서 검증 가능하게 만들어냄.
(2) Evolution:커밋 diff 파싱해 RPG를 업데이트하는 점진적 업데이트 가능하도록 함.
기존: [코드] ──(이해)──→ [표현]  (단방향)

논문: [코드] ──(이해)──→ [RPG] ──(생성)──→ [코드]
                          ↑
                     이 RPG가 양방향을 모두 지원할 수 있는
                     "충분한 정보"를 담고 있어야 한다
이해 방향 검증 → SWE-bench (코드 → RPG → 위치 찾기) 생성 방향 검증 → RepoCraft (RPG → 코드 재구성, 98.5% coverage)
API 문서로 코드 재구성 시도: 원본의 ~17% 복원 RPG로 코드 재구성 시도: 원본의 ~76% 복원 (550k vs 718k 토큰)
2. Related Work
Repository 생성: Agent사용하여: 파일 완성 --변화--> 아키텍처적 일관성을 강조하는 체계로 전환.
MetaGPT, paper-to-code, etc: multi-에이전트 프레임워크 논문들은 Role-based기반 abstraction으로 복잡성 관리
최근 Commit0: near-zero implementation --> library-level 재구성을 달성
Claude Code와 Gemini CLI 같은 터미널 기반 에이전트: 실제 환경에서 반복적인 "빌드-테스트-수정" 사이클을 사용
RPG(https://arxiv.org/pdf/2509.16198): structured planning graph를 활용해 실행 순서를 지키도록 강제하여 생성된 Repo가 구조적으로 유효하게 유지되도록 보장함. (순환 참조같은것을 못하게 예방함)
Repository Understanding: 수동적 검색 --(트랜드 변화)--> 구조 인식적 탐색
초기 방법들: 그래프 기반 탐색 프레임워크
LocAgent, KGCompass: 큰 코드베이스를 처리하기 위해 explicit한 depenency 스키마, KG사용해서 탐색 공간을 줄임
RepoHyper: Repo전체의 의미를 파악하기 위해 긴 문맥을 요약하는 방식을 탐구함.
OrcaLoca, CoSIL: 정확한FL을 위해서 실행중에 얻은 정보를 활용.
이러한 시스템들은 점점 더 "탐색-편집-실행" 루프에 의존
기존 방법들은 여전히 정보가 분산되어 있다는 한계가 있다. (예를들어서, 그래프는 A가 B를 호출한다는것은 알지만, B가 무엇을 하는진 모름. // API 문서에서는 어떠한 일을 하는지는 알지만, 어떤 파일들이 이것을 호출하는지 모름.)
RPG-Encoder는 의미적 특징과 구조적 제약을 결합함으로써 이 간극을 메운다.
3. Method
RPG-Encoder는 구현 코드를 의미 공간으로 역맵핑(Code --encoding--> RPG(의도))하여 representation loop을 완성한다. 세가지 단계로 구성되어 있다. (1) RPG 추출을 위한 인코딩, (2) 점진적 유지보수를 위한 발전, (3) 통합 추론 기반으로서의 운용.
- 선행 연구에서는 [RPG(의도) --> Code(구현)]을 하였음.
3.1. RPG Encoding: Extracting RPG from Codebases
코드베이스 --> 활용 가능하게 변환시키기 위해 파이프라인을 구성함 -- 구현 세부 내용을 압축된 의미 인덱스로 변환
세단계로 구성되어 있음.
RPG Structure:
RPG를 hierarchical dual-view graph G = (V,E)로 봄.
노드 집합: $V = V_H \cup V_L$
고수준 노드 $V_H$: 기능 기반으로 LLM이 만든 가상? 노드 (아키텍처 수준의 디렉토리를 나타냄, architectural directory)
저수준 노드 $V_L$: 실제 코드에 존재하는 구현 단위 (파일, 클래스, 함수와 같이 실제 구현의 최소 단위를 나타냄.)
각 노드는: v = (f,m) 형태임
f (feature): 기능 설명. "handles authentication"처럼 노드가 무엇을 하는지를 서술. 구현 세부사항이 아닌 행동 목적(behavioral intent)을 담음
m (meta): 코드 엔티티 속성. type(function/class/file/directory), fpath, func_name, lines 등
// 실제 코드에 존재하는 파일, 함수, 클래스 노드 { "feature": "Monotonic trend detector", "type": "file", "fpath": "sklearn/isotonic.py" }
엣지 집합: $E = E_{feature} \cup E_{dep}$
기능 엣지(E_feature): 이 함수는 저 파일에 속하고, 저 파일은 이 기능(<--> 물리적 폴더 구조와 다름) 그룹에 속한다
의존성 엣지(E_dep): 실제 코드 실행 시 나타나는 의존 관계. imports, calls, inherits 등. Phase 3에서 AST 분석으로 추출
# E_feature가 만드는 기능 기반 계층 구조
Algorithms                          ← 고수준 노드
└── supervised learning             ← 중간 노드
    ├── classification              ← 중간 노드
    │   ├── svm/_base.py            ← 파일 노드
    │   └── tree/_classes.py        ← 파일 노드
    └── regression                  ← 중간 노드
        ├── isotonic.py             ← 파일 노드
        └── linear_model/_base.py   ← 파일 노드

# E_features (기능 엣지)은 이 파일은 저 기능 그룹에 속하고 등등을 포함하는 관계 엣지
Algorithms → supervised learning     [E_feature: contains]
supervised learning → classification  [E_feature: contains]
classification → svm/_base.py         [E_feature: contains]
svm/_base.py → decision_function()    [E_feature: contains]

# E_dep (의존성 엣지)는 이 코드가 저 코드를 실제로 호출/참조 한다는 실행 관계 엣지
decision_function() ──(calls)──→ check_is_fitted()   [E_dep: calls]
svm/_base.py ──(imports)──→ numpy                       [E_dep: imports]
SVC ──(inherits)──→ LinearSVC                            [E_dep: inherits]

# 전체 그림으로 보자면
[E_feature: 기능 계층]          [E_dep: 실행 의존성]
Algorithms
└── classification
    └── svm/_base.py ──────────→ numpy          (imports)
        └── decision_function() → check_is_fitted() (calls)
                                → _ovr_decision() (calls)
3.1.1 Phase 1: Semantic Lifting
코드베이스 전체를 훑으면서 각 함수,클래스가 "무엇을 하는지"를 짧은 설명을 LLM을 사용하여 $V_L$ Node 생성함. 이때 구현 세부사항(루프, 조건문, 자료구조)이 아닌 목적과 역할에 초점을 맞춘다.
논문이 명시한 feature 명명 규칙: - verb + object 형식 (예: load config, validate token) - 소문자 영어만 사용 - 단일 책임 원칙: 하나의 feature가 하나의 역할만 표현 - 여러 책임이 있으면 복수의 atomic feature로 분리 - 길이: 3-8 단어. 문장 부호 없음 - 모호한 동사 금지(handle, process, deal with) → 정확한 동사 사용(load, validate, compute, serialize) - 라이브러리/프레임워크 이름 언급 금지 (serialize data ○, pickle object ✗)
물리적 폴더 구조는 기술적 제약(빌드 시스템, 패키지 규칙 등)에 의해 결정되므로 기능 경계와 다를 수 있다. 이 단계에서는 V_L로부터 잠재된 기능 토폴로지(latent functional topology)를 복원해 V_H를 구성한다.
Process
Functional Abstraction — 최상위 기능 영역 도출
LLM의 컨텍스트 윈도우 제약을 고려해, 함수 수준 노드를 제외한파일 수준 노드의 feature만 입력한다. 이 압축된 뷰(condensed view)를 통해 LLM이 리포지토리 전체의 의미 공간(semantic manifold)을 한 번에 분석해추상적 기능 중심(functional centroids), 즉 최상위 기능 영역을생성한다
# LLM 입력 (Appendix A.1.2 Domain Discovery 프롬프트 기반) { "repo_name": "scikit-learn", "file_features": { "sklearn/isotonic.py": "implement and serve monotonic regression algorithms", "sklearn/svm/_base.py": "implement SVM classification and regression models", "sklearn/preprocessing/_base.py": "implement data preprocessing and normalization", "sklearn/metrics/_classification.py": "compute classification evaluation metrics" } }
# LLM 출력 — 4~6개의 PascalCase 기능 영역 ["Algorithms", "Preprocessing", "Metrics"]
Hierarchical Aggregation — 재귀적 top-down 라우팅
각 파일 노드를 기능 계층 어디에 배치할지 결정하는 핵심 단계다. 논문이 명시한 메커니즘은 재귀적 semantic compatibility check이며, 이는 일괄 분류가 아니다.
논문의 Algorithm 4(FINDBESTPARENT)에 따르면:
1. 루트부터 시작해 현재 노드의 자식 중 추상 노드(abstract node)들을 후보로 수집 2. LLM에게 "이 파일의 feature가 어느 자식에 가장 잘 맞는가?"를 판단 요청 3. LLM이 특정 자식을 선택하면 그 자식 아래로 재귀 진행 4. LLM이 "더 적합한 자식 없음"을 반환하면 현재 노드에 배치 5. 직접 연결이 semantic 간격이 너무 클 경우 중간 노드(intermediate node)를 생성
예를 들어 StandardScaler를 배치할 때: Preprocessing → Normalization → StandardScaler 처럼 중간 노드 Normalization을 생성해 계층을 채운다.
경로 형식 제약 (논문 명시): <functional_area>/<category>/<subcategory> 정확히 3단계
추상 계층을 실제 물리적 artifact 및 실행 로직과 연결하는 단계. 두 작업으로 구성된다: - Task 1: V_H 노드의 빈 fpath 채우기 (bottom-up 전파) - Task 2: AST 분석으로 E_dep 엣지 추가
Task 1: Artifact Grounding — LCA로 fpath 채우기 논문의 Algorithm 1 (Bottom-Up Path Metadata Propagation)을 따른다. 핵심 메커니즘은 LCA(Lowest Common Ancestor)다.
Algorithm 1 동작 원리
PROPAGATE(v) 함수가 트리를 재귀적으로 순회한다: - 리프 노드(파일 노드): 해당 파일의 물리적 디렉토리를 반환 - 내부 노드(V_H): 모든 자식의 경로 집합 S를 모아 COMPUTELCA(S) 호출
COMPUTELCA(S) 함수: 1. 경로 집합 S로 Prefix Trie를 구성 2. Trie를 post-order(아래에서 위로) 순회 3. branching node(자식이 2개 이상인 노드) 또는 terminal node(리프) 만 의미 있는 경계(meaningful functional boundary)로 선택 4. 그 아래 중복 서브경로는 pruning으로 제거 5. 선택된 경로들을 반환해 해당 V_H 노드의 fpath로 설정
Dependency Injection — AST로 E_dep 엣지 추가 각 파일을 AST(Abstract Syntax Tree)로 파싱해 실제 실행 의존 관계를 추출하고 E_dep 엣지를 생성한다. 논문이 AST 분석을 명시한 이유는 LLM 추론이 아니라 정적 분석(static analysis)으로 정확도를 보장하기 위해서다
논문 Appendix A.3에 명시된 dependency 종류: - composes: A가 B를 멤버로 포함 (구성) - contains: 파일이 함수/클래스를 포함 (소속) - inherits: 클래스 A가 클래스 B를 상속 - invokes: 함수 A가 함수 B를 호출 - imports: 파일 A가 파일/모듈 B를 import
반환값: entity type, feature 경로, 소스 코드(시작/끝 라인 포함), mapped feature 정보
ExploreRPG: 특정 노드에서 출발해 엣지를 따라 연관 코드를 탐색한다. 논문의 설명은 "E_dep를 따라가되, V_H의 semantic hierarchy가 topological skeleton을 제공한다"는 것이다. E_feature가 탐색을 차단하는 게 아니라, E_dep로 발견한 노드가 기능 계층상 어디에 위치하는지 컨텍스트를 제공한다. 에이전트가 탐색 결과를 해석할 때 "이 함수는 Algorithms/classification 아래에 있다"는 정보를 얻어 관련성을 판단한다.
Step1: SearchNode - 진입점 찾기 SearchNode( mode="auto", # feature: 자연어 매칭만, Snippet: 키워드/심볼 텍스트 검색만, auto: feature먼저, 결과 부족하면 snippet도 수행 feature_terms=["SVM 투표 정규화", "결정 경계 계산"] )
구체적인 구현은 없음. (추측1) 1단계: feature_terms를 벡터로 임베딩 "SVM 투표 정규화" → [0.23, 0.87, ...]
Deletion: 함수나 파일이 삭제된 경우. 단순히 해당 노드만 지우는 게 아니라 빈 부모 노드를 재귀적으로 정리함. Algorithm 2(Deletenode + pruneorphans). 삭제된 노드의 부모 V_H 노드가 자식이 없어지면 그 부모도 삭제하고, 그 부모의 부모도 비어있으면 또 삭제
  삭제 전:
  Algorithms/supervised learning/regression
      ├── sklearn/isotonic.py        ← 이걸 삭제
      └── sklearn/linear_model/_base.py

  삭제 후:
  Algorithms/supervised learning/regression
      └── sklearn/linear_model/_base.py
      # 부모 노드는 자식이 아직 있으므로 유지

  삭제 전:
  Algorithms/supervised learning/regression
      └── sklearn/isotonic.py        ← 이걸 삭제 (마지막 자식)

  삭제 후:
  Algorithms/supervised learning/regression  ← 자식 없음 → 이것도 삭제
  Algorithms/supervised learning             ← 이제 regression 없음
                                               → classification도 없으면 이것도 삭제
                                               → 있으면 유지

  def delete_node(G, id):
      v = G.get_node(id)
      parent = v.parent
      G.remove_node(v)          # 노드와 연결된 모든 엣지 제거
      prune_orphans(G, parent)  # 부모부터 위로 재귀 정리

  def prune_orphans(G, v):
      if v is None or v.is_root():
          return
      if len(v.children) == 0:
          grandparent = v.parent
          G.remove_node(v)           # 빈 추상 노드 제거
          prune_orphans(G, grandparent)  # 한 단계 더 위로
Step3: Modification
함수나 파일의 내용이 바뀐 경우. 여기서 핵심은 위치(계층 구조)를 바꿔야 하는지 말지를 판단
Case A: 기능 의도가 그대로인 경우
이 경우 decision_function이 하는 일은 여전히 "결정 경계 계산"이다. 기능 계층에서의 위치가 바뀔 필요가 없다. feature f만 업데이트하고 노드 위치는 그대로 유지.
변경 전: Utility/helpers └── sklearn/svm/_base.py └── _helper
변경 후: Algorithms/supervised learning/classification └── sklearn/svm/_base.py └── _helper ← 새 위치로 이동
이 판단을 Algorithm 3의 SEMANTICSHIFT(v) > τ_drift 조건이 한다. LLM이 변경 전/후 feature를 비교해서 기능 의도가 충분히 달라졌으면 re-routing, 그렇지 않으면 in-place update.
τ_drift는 임계값인데, 논문이 구체적인 수치는 명시하지 않는다. 구현 시 튜닝이 필요한 하이퍼파라미터다.
# Algorithm 3 요약 function PROCESSMODIFICATION(G, f, Δ): 삭제된 단위들 → DELETENODE 처리 추가된 단위들 → INSERTNODE 처리 수정된 단위들: v.f = LLM으로 새 feature 생성 if SEMANTICSHIFT(v) > τ_drift: DELETENODE(현재 위치) INSERTNODE(새 위치) # Algorithm 4로 새 위치 찾기 # 아니면 feature만 업데이트하고 위치 유지
Step 4: Addition Algorithm 4 (LLM-Based Semantic Routing): 새 노드를 기존 계층 구조 어디에 배치할지 결정. Phase 2의 Hierarchical Aggregation과 동일한 재귀적 top-down 라우팅을 사용
추가 후 E_dep도 업데이트합니다. 새 파일의 AST를 파싱해서 import/call 관계를 추출하고 엣지를 추가합니다.
Q) 초반의 Repo성격과, 현재 Repo성격이 많이 바뀐상태라면, V_H가 새롭게 생겼을 수 있음. 새롭게 생긴 주제를 발견하지 못할 수 있지 않나?
--> 맞음.... ▎ "reserve global reconstruction for major refactoring" --> 즉 논문 스스로 "구조가 크게 바뀌는 대규모 리팩토링의 경우에는 전체 재생성을 해야 한다" 고 인정함. Evolution은 routine updates를 위한 것이고, 리포지토리의 성격이 근본적으로 바뀌는 경우는 적용 범위 밖입니다.
함수 수준 노드 node_01: feature="store basic auth credentials" fpath="requests/auth.py", func="HTTPBasicAuth.__init__" ...
+ 파일 수준 노드 (함수 feature들을 요약) node_10: feature="HTTP authentication handlers for basic and digest auth" fpath="requests/auth.py", type="file" node_11: feature="HTTP request and response data models" fpath="requests/models.py", type="file" node_12: feature="top-level API for sending HTTP requests" fpath="requests/api.py", type="file"
functional edge:
  SearchNode   → search_scopes 처리 시
                 Virtual 노드에서 아래로 내려가며
                 탐색 대상 후보 노드 집합 만들 때
  ExploreRPG   → 사용 안 함

dependency edge:
  ExploreRPG   → 함수간 호출 관계 추적할 때
  SearchNode   → 사용 안 함
시스템 프롬프트:
  "당신은 코드 탐색 에이전트입니다.
   다음 도구를 사용할 수 있습니다: SearchNode, FetchNode, ExploreRPG

   현재 저장소의 최상위 Virtual 노드 목록:
     - Authentication    (fpath: requests/auth.py)
     - RequestHandling   (fpath: requests/)
     - ResponseHandling  (fpath: requests/models.py)"

유저 입력:
  "HTTP Basic Auth가 요청에 헤더를 붙이지 않는 버그가 있다"
Step 1: SearchNode 에이전트 내부 추론:
이슈 분석:
  "Basic Auth" → Authentication 영역
  "헤더를 붙이지 않는다" → attach header 관련 함수

최상위 노드 중 "Authentication"이 관련있음
→ search_scopes = ["Authentication"] <-- Virtual Nodes들이 input으로 들어가있어서 알 수 있음.
→ feature_terms = ["attach authorization header", "basic auth"]
node_02(BasicAuth.__call__)가 가장 관련있어 보임
"attach header" 동작이 __call__에 있을 것

node_01(BasicAuth.__init__)도 확인 필요
초기화 시 헤더 설정이 잘못됐을 수도 있음
FetchNode 실행:
입력:
  ["requests/auth.py:HTTPBasicAuth.__call__",
   "requests/auth.py:HTTPBasicAuth.__init__"]

내부 동작:
  node_table에서 해당 노드 찾기
  → node_02: fpath="requests/auth.py", lines=[15, 19]
  → node_01: fpath="requests/auth.py", lines=[10, 14]

  실제 파일에서 해당 줄 읽기

출력:
  node_02:
    feature: "attach basic authorization header to request"
    fpath:   "requests/auth.py"
    lines:   [15, 19]
    code:
      def __call__(self, r):
          r.headers['Authorization'] = _basic_auth_str(
              self.username, self.password
          )
          return r          ← 코드 자체는 정상처럼 보임

  node_01:
    feature: "store basic auth credentials"
    fpath:   "requests/auth.py"
    lines:   [10, 14]
    code:
      def __init__(self, username, password):
          self.username = username
          self.password = password
에이전트 판단:
__call__ 코드는 정상처럼 보임
_basic_auth_str() 함수가 문제일 수 있음
→ ExploreRPG로 _basic_auth_str 추적 필요
Step 3: ExploreRPG
ExploreRPG 실행:
입력:
  start     = "requests/auth.py:HTTPBasicAuth.__call__"
  direction = "downstream"   ← 이 함수가 호출하는 것들
  depth     = 2

내부 동작 depth=1:
  edge_table에서 from=node_02인 dependency edge 탐색
  → dep_05: node_02 → node_04(Request.__init__)  calls

  그런데 _basic_auth_str은 node_table에 없음
  → requests/auth.py 안에 정의된 내부 헬퍼 함수
  → Phase 1에서 별도 노드로 만들어지지 않았거나
     다른 파일에서 import된 것

내부 동작 depth=2:
  node_04(Request.__init__)를 호출하는 것들
  → dep_03: node_09(request) → node_04  calls

출력:
  __call__() → Request.__init__()  [calls]
  request()  → Request.__init__()  [calls]
에이전트 판단:
_basic_auth_str이 RPG에 없음
→ SearchNode로 직접 검색 필요
Step4: SearchNode (2차)
입력:
  mode         = "snippets"      ← 이번엔 키워드 직접 검색
  search_terms = ["_basic_auth_str"]

내부 동작:
  node_table의 func_name 필드에서 "_basic_auth_str" 검색
  → 없음

  실제 파일에서 텍스트 검색 (grep 방식)
  → requests/auth.py 안에서 발견
  → requests/compat.py에서 import됨

출력:
  requests/compat.py:_basic_auth_str
    lines: [50, 58]
    code:
      def _basic_auth_str(username, password):
          if isinstance(username, str):
              username = username.encode('latin1')  ← 인코딩 버그 가능성
          ...
Step5: 최종답변
에이전트가 에이전트 추론:
  HTTPBasicAuth.__call__ 자체는 정상
  내부에서 호출하는 _basic_auth_str의
  latin1 인코딩 처리가 버그 원인으로 의심됨

최종 출력:
  버그 위치:
    1순위: requests/compat.py:_basic_auth_str  (lines 50-58)
    2순위: requests/auth.py:HTTPBasicAuth.__call__ (lines 15-19)

  영향 범위:
    HTTPDigestAuth.__call__도 동일 함수 사용 가능성 있음
    → 추가 확인 필요
전체 흐름 요약
node_table 사용:
  SearchNode → feature 매칭으로 후보 노드 발견
  FetchNode  → fpath, lines로 실제 코드 읽기

edge_table 사용:
  SearchNode   → functional edge 타고 탐색 범위 좁히기
  ExploreRPG   → dependency edge 타고 연관 함수 추적

둘 다 사용하지 않는 경우:
  SearchNode snippets mode → 파일 직접 텍스트 검색
  (RPG에 없는 함수 찾을 때)
normalize()는 정규화 유틸리티 함수
실제 버그는 _ovr_decision_function 내부 로직
→ 추가 탐색 불필요, 최종 위치 결정
최종 출력
File: sklearn/svm/_base.py
Func: decision_function        (Line: 768-798)
Func: _ovr_decision_function   (Line: 801-830)  ← 실제 버그 위치
전체 흐름 요약
쿼리: "SVM vote normalization 버그"
            ↓
[SearchNode]
  V_H/V_L 구분 없이 feature 매칭 강도 순 반환
  → decision_function, _ovr_decision_function 발견
            ↓
[FetchNode] (1차)
  두 함수 실제 코드 가져와서 검증
  → decision_function이 _ovr_decision_function 호출 확인
  → _ovr_decision_function에서 잘못된 정규화 로직 발견
            ↓
[ExploreRPG]
  E_dep 따라 downstream 탐색
  → normalize() 추가 발견
            ↓
[FetchNode] (2차)
  normalize() 코드 검증
  → 버그 위치 아님 확인
            ↓
최종 위치: sklearn/svm/_base.py
  decision_function      (768-798)
  _ovr_decision_function (801-830)
# LLM Input { "file": "sklearn/isotonic.py", "functions": { "check_increasing": ["단조 증가 추세 감지", "스피어만 상관계수 계산"], "isotonic_regression": ["단조 회귀 계산", "가중치 기반 정렬 수행"], "IsotonicRegression.fit": ["단조 회귀 모델 학습", "입력 데이터 검증"], "IsotonicRegression.predict": ["학습된 모델로 예측 수행"] }, "task": "이 파일이 전체적으로 무엇을 하는 파일인지 한 줄로 요약해줘" }
------------------------------------------------------------------------- E_feature 따라가면: "isotonic.py 안에 뭐가 있어?" → IsotonicRegression, check_increasing 발견 → fit, predict 발견
E_dep 따라가면: "이 버그가 어디까지 영향을 미쳐?" → check_increasing이 고장나면 → fit이 호출하니까 fit도 영향받고 → IsotonicRegression 전체가 망가짐 ------------------------------------------------------------------------- Appendix A.3 "dependency_type_filter": "composes" # 구성 (A가 B를 멤버로 포함) "contains" # 포함 (파일이 함수를 포함) "inherits" # 상속 (클래스 A가 클래스 B를 상속) "invokes" # 호출 (함수 A가 함수 B를 호출) "imports" # 임포트 (파일 A가 파일 B를 import)
Domain Discovery: 파일 노드들의 Feature들을 모아서 LLM을 사용해 최상위 카테고리를 만든다.
# LLM Input { "repo_name": "scikit-learn", "file_features": { "sklearn/isotonic.py": "단조 회귀 알고리즘 구현", "sklearn/svm/_base.py": "SVM 분류 및 회귀 모델 구현", "sklearn/preprocessing/_base.py": "데이터 전처리 및 정규화 구현", "sklearn/metrics/_classification.py": "분류 모델 평가 지표 계산" }, "task": "이 파일들을 보고 최상위 기능 영역을 나눠줘" }
파일을 3단계 경로로 배정:LLM이 각 파일을<영역>/<카테고리>/<서브카테고리>형태로 분류. (더 큰 레포라면 3단계로는 부족할 수 있겠음)
# LLM에게 보내는 입력 { "functional_areas": ["Algorithms", "Preprocessing", "Metrics"], "file_features": { "sklearn/isotonic.py": "단조 회귀 알고리즘 구현", "sklearn/svm/_base.py": "SVM 분류 및 회귀 모델 구현", "sklearn/preprocessing/_base.py": "데이터 전처리 및 정규화 구현", "sklearn/metrics/_classification.py": "분류 모델 평가 지표 계산" } }
Step 2: Trie로 공통 경로 계산 # "Algorithms/supervised/regression" 의 경우 leaf_paths = [ "sklearn/isotonic.py", "sklearn/linear_model/_base.py", "sklearn/linear_model/_ridge.py" ]
- 여러가지 rubric으로 평가 항목을 나눔(평균적으로 각 평가 데이터는 11.4개의 평가 항목을 갖고 있다고 함)
- 각 rubric마다 Yes/No 이진 판정을 함 --> 이렇게 하면, LLM에게 전체 데이터를 주고 0-10으로 평가하게 하는 것 보다 더 안정적이라고 함.
Rubric을 어떻게 정의해야할까? (LLM과 논의한 결과) - HealthBench가 수만 개의 루브릭을 만든 방식은 **'Bottom-up(상향식)'** 전략입니다. 즉, "좋은 답변은 이래야 해"라고 먼저 정한 게 아니라, **실제 답변 데이터에서 문제점을 발견하며 기준을 추출**했습니다. --- ## 1단계: 차원(Dimensions) 설정 (대분류)
먼저 답변을 어떤 각도에서 볼지 결정해야 합니다. HealthBench는 크게 다음 4가지를 봅니다. 내 데이터가 의료가 아니더라도 이 구조는 유효합니다.
<br>2. 출처가 명확히 명시되었는가? | | 친절하고 공감적인가? | 1. 첫 문장에 사용자의 감정에 공감하는 표현이 있는가?<br>
<br>2. 공격적이거나 강압적인 단어를 사용하지 않았는가? | | 가독성이 좋은가? | 1. 3개 이상의 불렛포인트나 번호 매기기를 사용했는가?<br>
<br>2. 전문 용어에 대한 쉬운 설명이 포함되었는가? |
---
## 3단계: LLM을 활용한 루브릭 생성 (실전 팁)
사람이 수천 개를 다 쓸 수는 없습니다. 내 데이터를 일부 샘플링해서 LLM(GPT-4 등)에게 **"이 답변에서 칭찬할 점과 고칠 점을 아주 세세하게 나열해줘"**라고 시키세요.
**[추천 프롬프트 예시]**
> "당신은 전문 평가 시스템 설계자입니다. [질문]과 [답변] 쌍 10개를 드릴 테니, 이 답변들의 품질을 '예/아니오'로만 판단할 수 있는 아주 구체적인 체크리스트(Atomic Rubrics)를 20개만 만들어주세요. 주관적인 형용사(예: 적절한, 충분한)는 빼고, 텍스트 존재 여부로 판단 가능한 기준이어야 합니다."
---
## 4단계: '사실 기반' 루브릭 (Reference-guided)
HealthBench의 핵심은 **정답(Gold Standard)**이 있을 때 이를 활용하는 방식입니다.
* **Reference:** "이 약은 하루 2번, 식후 30분에 복용해야 함." * **Model Response:** "이 약은 하루에 두 번 드세요." * **Rubric:** "모델이 복용 시간을 '식후 30분'이라고 명시했는가?" -> **No**
이런 식으로 정답지에 있는 핵심 키워드나 수치를 하나하나의 루브릭으로 만드세요.
---
## 요약: 나만의 평가 시스템 만들기 Checklist
1. **샘플링:** 내 데이터 중 대표적인 20~30개를 뽑습니다. 2. **페인 포인트 찾기:** "이 답변은 왜 별로지?" 싶은 이유를 아주 구체적으로 적습니다. (예: "너무 길어서 읽기 싫음" → "문장이 5줄 이상 연속되는가?") 3. **이진화(Binary):** 모든 기준을 '예/아니오'로 바꿉니다. 4. **LLM-as-judge 적용:** `temperature=0`으로 설정하고, 위에서 만든 루브릭을 하나씩 체크하게 합니다.
예시)
A. 기술적 실체성 (Technical Entity)
루브릭 1: GT(Ground Truth)에서 언급된 핵심 코드 요소(함수명, 변수명, 클래스명 등)를 LLM 답변이 정확히 포함하고 있는가?
루브릭 4: "A 때문에 B가 발생했다"는 식의 인과 관계가 GT의 설명과 모순되지 않는가?
C. 해결 방향성 (Actionability)
루브릭 5: LLM이 제안한 원인이 실제 코드 수정(Fix)으로 이어질 수 있을 만큼 구체적인 위치를 지목하는가?
루브릭 6: (해당 시) 메모리 누수, 널 참조(Null Pointer), 타입 불일치 등 버그의 **유형(Bug Category)**을 정확히 분류했는가?
2. Related Work
Reinforcement Learning from AI Feedback (RLAIF): RLHF의 대안으로 제안되었음.
장점: human annotator가 필요 없음
reward model과 policy model의 크기가 비슷할 때, RLAIF가 RLHF와 동등하거나 심지어 우수한 결과를 달성할 수 있음을 추가로 입증
단점: 대신 scalar reward model에 의존한다는 것이다
generative reward model이 더 효과적일 수 있다는 점을 활용하여, 훈련된 policy model 자체를 reward model로 활용해 reward signal을 생성
Rubrics as Rewards:
과거 연구에서, rubric(채점 기준표)을 사용해서 모델을 훈련함. 허나 grader로더 강력한 모델을 사용 (Rubrics as Rewards: Reinforcement Learning Beyond Verifiable Domains) - 여기서는 rubric을 자동으로 생성하는데 집중함.
실험해보니, 전문가가 만든 rubric이 더 효과가 좋았음
Self-Rewarding Language Models
모델 스스로의 응답에 점수를 매기고 (DPO 훈련을 위한) pairwise preference 데이터를 구성하며 처음 생긴 컨셉
비판: 이렇게 하면 모델이 자기 편향(bias)을 계속 강화시킴
Kimi K2의 방법:
Self-Critique Rubric Reward제안: 몇 가지 제한된 평가 rubric만 가지고, 두 답변을 비교하는 방식을 사용함.
이 논문의 차별점:
Point-wise composite를 시도함(Pair-wise를 하지 않음)
여러 rubric에 대해 구체적인 점수 부여: 예) 정확성(Accuracy): 8/10점,완전성(Completeness): 6/10점,맥락 인식(Context Awareness): 9/10점,- 소통 품질(Communication Quality): 7/10점 등
task-specific rubric
kimi k2는 제한적인 rubric에서 평가함
의료 상담 질문에 대한 11개 평가을 세세하게 구분하여 평가함.
Reward Hacking 완화
11개 다른 기준으로 평가하므로: - 길이만 길면 → Communication Quality 낮음 - 전문용어만 쓰면 → Context Awareness 낮음 - 한 기준만 높아도 → 다른 기준들이 낮으면 총점 낮음
3 Background and Preliminary Experiments
3.1 Background on Open-Ended Evaluation
정답이 있는 task에서 강화학습을 사용하여 많은 발전을 달성함 - reward signal이 명확하여 성공함
반면, open-ended은 상대적으로 적다(데이터, 정답, 등)
HealthBench는 5000개의 대화로 이루어진 데이터로 task-specific rubric에 따라 평가함.
데이터를 선택한 이유: 1. 의사들에 의해 주석이 달려 있어, 정확성과 도메인 전문성이 있고 편향이 적다 2. 1,000개의 Hard subset을 포함하고 있으며, 최고의 모델도 50%를 넘지 못함. --> 개방형 데이터에서 추론 연구 적합 3. meta-evaluation을 제공하며, 이는 LLM grader와 의사 간의 불일치를 Macro F1을 사용하여 정량화함.
3.2 Meta Evaluation of Open-Source Models on HealthBench
데이터에는 의사들이 만들어낸 정답이 있음.
서로 다른 다양한 오픈소스 모델들을 사용하여 HealthBench Meta 평가를 수행. --> 평가를 위해 simple-evals¹(OpenAI repository)을 사용한다.
Figure2: 더 큰 모델이 더 좋은 점수를 받는 경향이 있음.
Table1: 더 작은 모델일 수록 더 좋은 점수를 부여하는 경향이 있음.
Table2: Qwen3-32B가 grading 능력에서 sampling temperature에 민감하지 않고, 점수가 0.670 주변에서 변동함을 보임.
3.3 Preliminary Experiments
open-ended 추론 작업 훈련을 위한 grader로 오픈소스 모델을 사용하는 것의 실현 가능성을 조사하기 위한 예비 실험을 수행
그래서 왜 챕터3에서 grader에 대해서 집착하냐? --> 이 논문에서는 policy모델을 추론 및 grader를 사용하고자 하는데, grader의 Signal이 이상하면 모델이 훈련되지 않을 것 따라서, grader가 최소한의 가능성이 있는지 보려 하는 것.
3.3.1 Models and Datasets
Qwen3-32B는 합리적인 선택. self-rewarding 실험에서, Qwen3-8B도 좋은 성능을 달성할 수 있음을 검증함.
데이터
Easy data: 훈련에 사용되는 4000개의 HealthBench Easy 샘플
Synthetic data: (easy data와 유사)합성으로 생성된 4000개의 샘플
Scoring data: 이전 평가에서 수집한 1000개의 GPT-4.1 scoring 샘플
Scoring data: GPT-4.1이 rubric을 평가한 구체적인 내용 --> small model로 gpt-4.1의 판단을 distill할 수 있음.
훈련 loss가 계속 감소, validation loss가 1 epoch 후 빠르게 증가하는 것을 관찰함 --> 일반화 안됨.(Figure 8) --> 0.1988에서 200 step 후 0.0004로 떨어짐. chain-of-thought reasoning이 SFT에 포함되지 않을 때, 모델들이 in-distribution의 어려운 문제에서도 일반화에 실패함.
적은 데이터로도 RL은 일관되게 모델 성능을 향상시킨다.
Figure 3, 모델의 응답 길이가 증가하며, 최대 응답 길이에 도달할 때까지 reward가 지속적으로 개선된다.
HealthBench Hard 평가에서 모델의 성능이 일관되게 향상되어, 최종적으로 0.446을 달성하며, Figure 4에 표시된 것처럼 OpenAI o3의 점수인 0.32를 크게 능가.
RL 훈련 후에도 grading 능력이 유지된다. RL 후 모델의 HealthBench Meta 점수를 평가 --> Table 3 점수가 약간 향상되는 것을 발견.
모델을 RL로 훈련시키면, 답변 능력은 좋아지겠지만, 평가(grading) 능력은 나빠지거나 편향되지 않을까?
결과: 답변 잘하기와 평가 잘하기를 동시에 배움 좋은 답변 생성 → 더 나은 평가 능력 → 더 정확한 보상 신호 → 더 좋은 답변 학습 → 더 나은 평가 능력 → ... 이런 선순환 가능
더 좋은 grader가 필요 없음.
4. Method
고려할 부분
훈련 효율성 병목현상. verl에 구현된 GRPO의 on-policy 훈련 방식으로 인해, actor 훈련은 모든 샘플의 reward 계산이 완료될 때까지 기다려야 한다.(이는 극도로 시간이 많이 소요) 한편으로는 GRM scoring 자체가 느리고, 다른 한편으로는 각 rubric에 대해 판단이 필요하며, 샘플당 평균 11개의 rubric이 있고, 샘플당 4개의 response가 샘플링된다. 성능 제약으로 인해, single-step 시간의 약 70-80%가 reward 계산에 소비됨
GRM 능력 제약. GRM 자체의 능력이 RL 훈련 효과를 제한할 수 있다는 것이 자연스러운 우려사항이다. 확장성 문제를 고려하여 policy model보다 큰 모델에 의존하지 않고 더 나은 결과를 달성하기를 바랬음.
제안:
기존 방법들:
모델을 훈련할 때 grader가 따로 필요했음, 채점자가 모델의 답변을 평가하는데 시간이 오래 걸림, 특히 GPU 자원도 많이 필요함